Ниже — короткая последовательность настройки Redis на VPS: от установки и безопасного доступа до ограничения памяти, выбора eviction policy и проверки сохранности данных после restart.
- Установите Redis на Ubuntu и убедитесь, что сервис запущен:
    sudo apt update
sudo apt install -y redis-server
sudo systemctl enable --now redis-server
Проверка:
redis-cli pingОжидаемый ответ:
PONG- Не открывайте Redis всему интернету. Если приложение работает на том же VPS, оставьте Redis привязанным к localhost:
    bind 127.0.0.1
protected-mode yes
Если приложение находится на другом сервере, лучше использовать private network и дополнительно ограничить порт 6379 через firewall.
- Настройте отдельного ACL-пользователя для приложения вместо работы через unrestricted default user. Пользователь должен получать только те команды и key patterns, которые реально нужны приложению.
- Задайте лимит памяти через
maxmemory, оставив запас операционной системе и persistence. Например, на VPS с 4 ГБ RAM разумной отправной точкой может быть около 2 ГБ для Redis:
maxmemory 2gbНо точное значение зависит от нагрузки, persistence и других процессов на сервере.
- Выберите
maxmemory-policyпод роль Redis. Для обычного кеша часто подходят eviction policies вроде:
allkeys-lruили:
allkeys-lfuЕсли Redis используется как хранилище и нельзя автоматически удалять ключи, безопаснее рассмотреть:
noeviction- Определитесь с persistence. Для периодических snapshot можно использовать RDB, для более частого сохранения операций — AOF. Если Redis служит только восстановимым кешем, persistence иногда можно отключить полностью.
- Создайте контрольный ключ:
redis-cli SET persistence:test "redis-survived"После настройки RDB или AOF перезапустите Redis:
sudo systemctl restart redis-serverИ проверьте:
redis-cli GET persistence:testЕсли ключ вернулся, persistence работает в выбранном сценарии.
- При проблемах с памятью смотрите:
    redis-cli INFO memory
redis-cli INFO stats
redis-cli CONFIG GET maxmemory
redis-cli CONFIG GET maxmemory-policy
Особенно важны used_memory, текущий maxmemory и счетчик evicted_keys.
Если Redis запускается автоматически, принимает только разрешенные подключения, приложение работает через отдельного пользователя, maxmemory и eviction policy соответствуют задаче, а данные после restart восстанавливаются ожидаемым образом — базовую конфигурацию можно считать готовой к дальнейшей эксплуатации.
Что на повестке дня
Redis часто начинают использовать с простой задачи: поставить сервис, подключить приложение и складывать туда кеш. Но довольно быстро появляются вопросы посерьезнее: сколько памяти ему отдавать, что произойдет при заполнении RAM, как не открыть Redis всему интернету и переживут ли данные обычный restart.
В этой статье разберем весь этот путь на одном VPS. Установим Redis, настроим безопасный доступ и ACL, зададим maxmemory, сравним eviction policies и отдельно разберемся, когда Redis работает как обычный кеш, а когда уже становится частью постоянного хранения данных.
После этого перейдем к persistence: сравним RDB и AOF, создадим контрольные ключи, перезапустим Redis и проверим, что данные действительно сохранились. В конце посмотрим, как диагностировать нехватку памяти и какие настройки стоит перепроверить перед production.
Как будет устроен Redis-сервер
С общим планом определились. Теперь разберем, какую именно схему будем собирать и какие параметры в ней важнее всего.
В базовом варианте Redis будет работать на одном Ubuntu VPS как отдельный сервис. Приложение подключается к нему по TCP, передает команды и получает данные из RAM. Дальше поведение Redis уже зависит от настроек: можно использовать его как временный кеш с автоматическим вытеснением старых ключей, а можно включить persistence и использовать как СУБД, относясь к данным гораздо осторожнее.
Поэтому здесь важно не просто запустить redis-server, а заранее определить четыре вещи: кто может подключаться, сколько памяти Redis разрешено использовать, какие ключи можно удалять при нехватке RAM и должны ли данные переживать restart.
Что установим и проверим
На сервере нам понадобятся два основных компонента:
redis-server— сам сервис Redis;redis-cli— консольный клиент для проверки подключения и выполнения команд.
После установки проверим не только ответ:
PONGно и более практические вещи.
Нас будет интересовать:
- Запускается ли Redis через systemd;
- Слушает ли только нужный interface;
- Работает ли authentication;
- Применяются ли ACL;
- Какой задан
maxmemory; - Какая выбрана
maxmemory-policy; - Включены ли RDB или AOF;
- Сохраняются ли данные после restart;
- Что происходит при приближении к лимиту RAM.
То есть обычный PING здесь будет только первой проверкой, а не финальной.
Как приложение подключается к Redis
Redis обычно принимает соединения на порту:
6379Если приложение работает на том же VPS, самый простой вариант выглядит так:
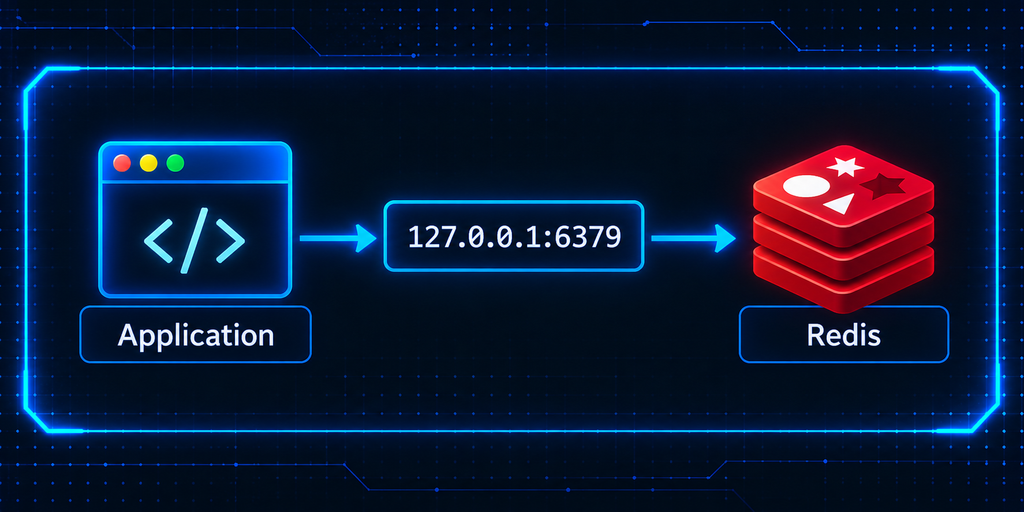
В таком случае Redis вообще не нужно открывать наружу.
Connection string может выглядеть примерно так:
redis://app_user:password@127.0.0.1:6379Если приложение и Redis находятся на разных VPS, лучше использовать private network:
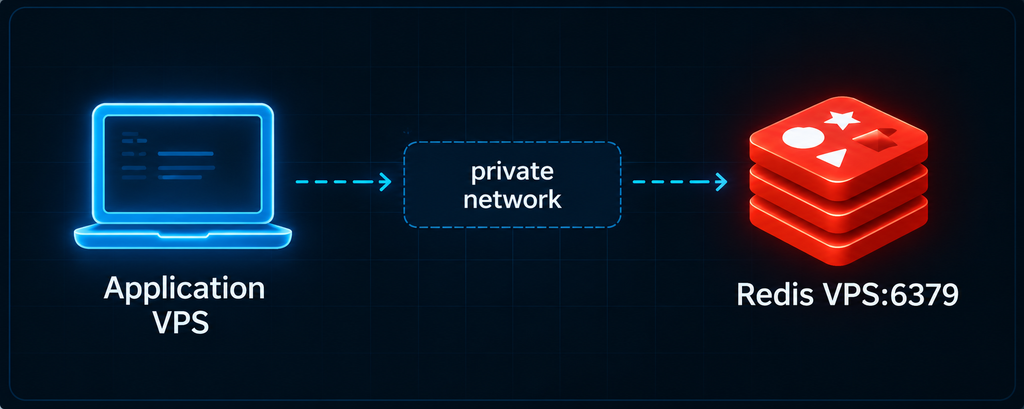
Тогда Redis слушает private interface, а firewall разрешает подключение только от Application VPS.
При этом сама сеть — только один уровень защиты. Позже дополнительно настроим ACL, чтобы приложение подключалось под отдельным пользователем и не получало лишних команд.
Чем Redis как кеш отличается от Redis как хранилища
Это один из ключевых моментов.
Когда Redis используется как кеш, данные считаются воспроизводимыми. Например, приложение может снова получить их из основной database или API.
Тогда потеря части ключей сама по себе не катастрофична.
В такой схеме нормально использовать TTL и eviction:
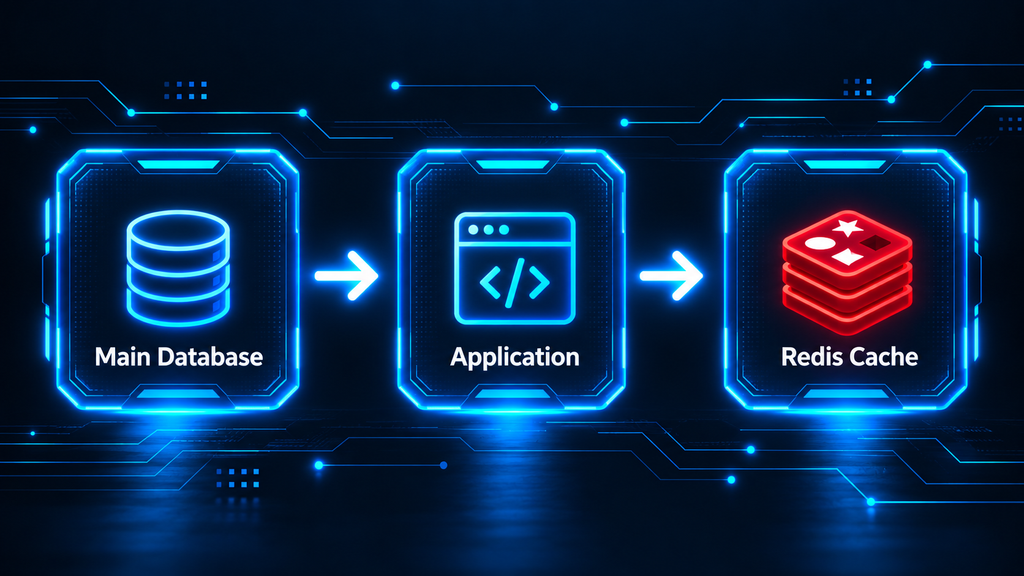
Если Redis переполнится, старые или редко используемые ключи можно удалить, а приложение при необходимости создаст их заново.
Но Redis может хранить и данные, которые нельзя безболезненно потерять.
Например:
- Очереди;
- Counters;
- Session state;
- Временное состояние workflow;
- Некоторые быстро меняющиеся структуры, которые приложение считает важными.
Тогда подход уже другой.
Автоматическое удаление произвольных ключей становится опасным, а persistence начинает играть гораздо большую роль.
Условно:
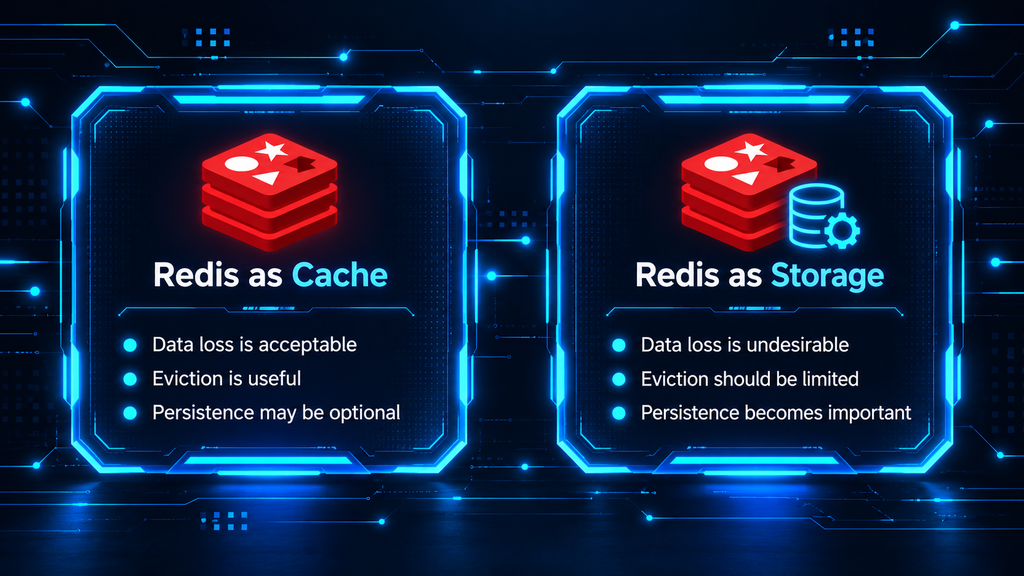
Это разделение потом определит и maxmemory-policy, и выбор RDB/AOF.
Какие настройки будут ключевыми
В redis.conf нас будет интересовать не весь файл подряд, а несколько групп параметров.
Сетевые настройки отвечают за то, где Redis принимает соединения:
    bind
protected-mode
port
Безопасность и пользователи — за authentication и разрешенные команды:
    user
ACL
Память:
    maxmemory
maxmemory-policy
Persistence:
    save
appendonly
appendfsync
Именно вокруг этих параметров дальше будет строиться вся настройка:
| Параметр | За что отвечает | Что настроим |
bind | На каких interface Redis принимает соединения | Localhost или private IP |
protected-mode | Дополнительная защита от небезопасной сетевой конфигурации | Оставим включенным |
| ACL | Пользователи и доступные команды | Создадим отдельного пользователя приложения |
maxmemory | Максимальный объем RAM для Redis | Рассчитаем с запасом для ОС |
maxmemory-policy | Что делать при заполнении памяти | Выберем под кеш или хранилище |
save | Правила RDB snapshots | Настроим и проверим |
appendonly | Включение AOF | Сравним с RDB |
appendfsync | Частота синхронизации AOF | Разберем always, everysec и no |
На этом архитектура понятна: Redis будет работать как отдельный service, приложение получит ограниченный доступ, память будет контролироваться через maxmemory, а сохранность данных — через выбранный persistence-механизм.
Выбираем версию Redis и конфигурацию VPS
Теперь нужно понять, сколько ресурсов ему реально требуется. В случае с Redis главный вопрос обычно не в CPU, а в памяти: данные находятся в RAM, поэтому от объема оперативной памяти напрямую зависит, сколько ключей сервер сможет держать одновременно.
Мы возьмем Redis 8.x на Ubuntu 24.04 LTS и небольшой VPS, которого достаточно для практических тестов, persistence и контролируемой нагрузки.
Какие ресурсы нужны небольшому Redis
Для небольшого Redis не требуется мощный сервер.
Если он используется как кеш, session store, rate limiter или хранилище небольшого количества оперативных данных, стартовой конфигурацией может быть:
- 1–2 vCPU
- 2–4 ГБ RAM
- 20–40 ГБ SSD
CPU в большинстве небольших сценариев не становится первым ограничением. Redis обрабатывает команды очень быстро, а основная нагрузка обычно упирается в:
- Объем данных;
- Количество запросов;
- Размер values;
- Число соединений;
- Persistence;
- Сетевую нагрузку.
Для тестового стенда можно запустить Redis и на 1 ГБ RAM, но запас там быстро заканчивается. Особенно если одновременно включены AOF или RDB и на сервере работают другие процессы.
Поэтому для практической статьи мы будем использовать конфигурацию чуть свободнее, чтобы можно было спокойно экспериментировать с памятью и persistence.
Почему для Redis особенно важна RAM
Redis хранит рабочие данные в оперативной памяти.
Это и дает ему высокую скорость, но одновременно делает RAM главным ресурсом сервера.
Условно:
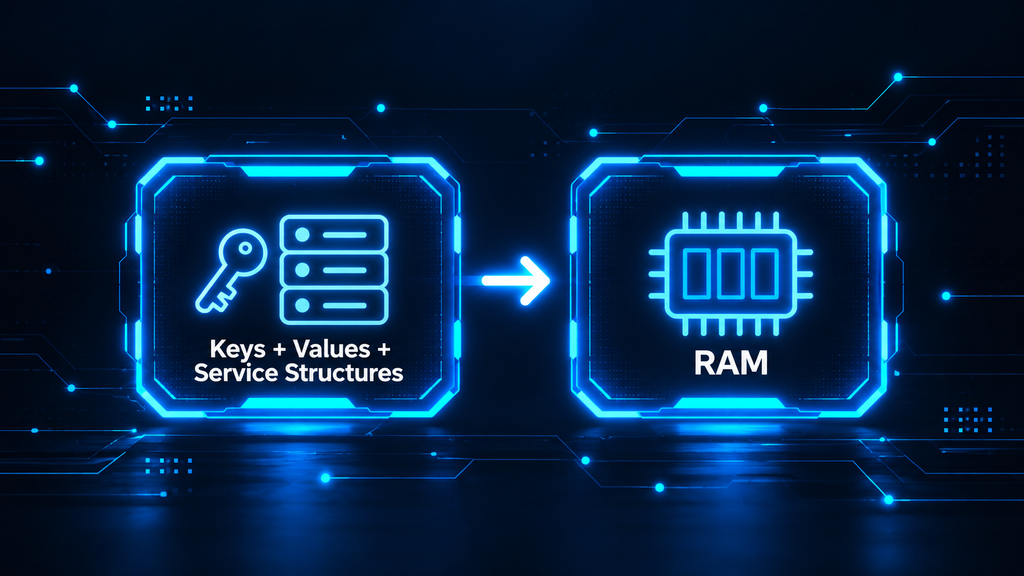
При этом потребление памяти — это не только сумма размеров values.
Redis дополнительно расходует RAM на:
- Ключи;
- Metadata;
- Internal structures;
- Allocator overhead;
- Client buffers;
- Replication buffers, если они используются;
- Временную память при некоторых операциях;
- Copy-on-write во время fork для RDB или AOF rewrite.
Поэтому если набор данных занимает, например, 2 ГБ, нельзя автоматически считать, что VPS с 2 ГБ RAM подойдет.
Нужен запас.
Особенно он важен при persistence: во время создания snapshot или rewrite AOF Redis может временно потреблять больше памяти, чем в обычном состоянии.
Именно поэтому позже мы не просто поставим maxmemory равным всей доступной RAM, а оставим часть памяти операционной системе и фоновым операциям Redis.
Как оценить необходимый объем памяти
Для грубой оценки можно идти от трех величин:
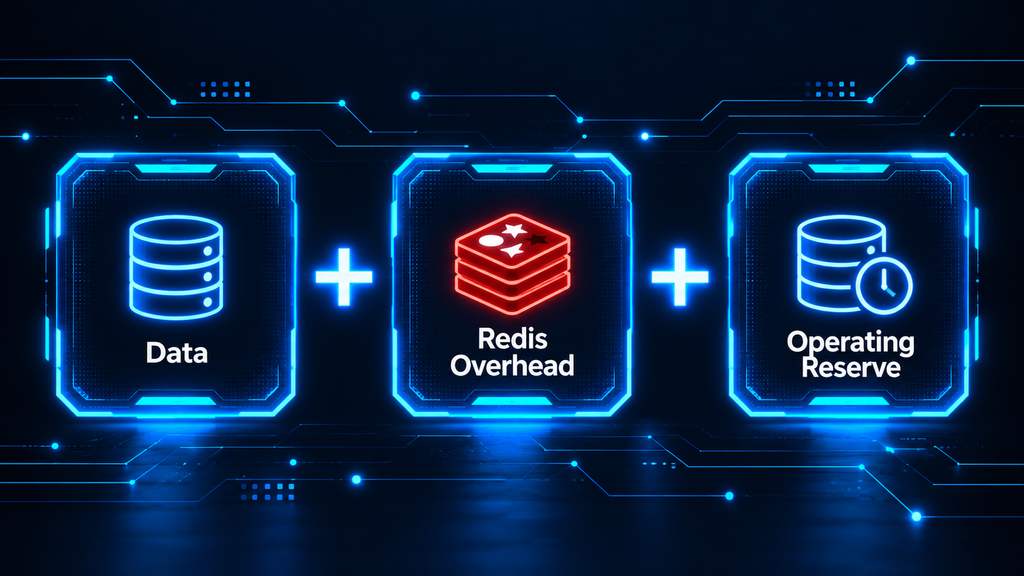
Например, предположим, что приложение планирует хранить примерно 1.2 ГБ данных.
Можно заложить дополнительный запас под структуры Redis и рост: ~0.5–0.8 ГБ
И еще оставить память системе и persistence.
В таком случае VPS с 2 ГБ RAM уже будет слишком тесным, а 4 ГБ даст гораздо более комфортный запас.
Важно и то, что Redis редко остается в первоначальном размере. Кеш растет, появляются новые key patterns, увеличивается число sessions или counters.
Поэтому при выборе VPS лучше смотреть не только на текущий объем данных, но и на ожидаемый рост.
Упрощенно:
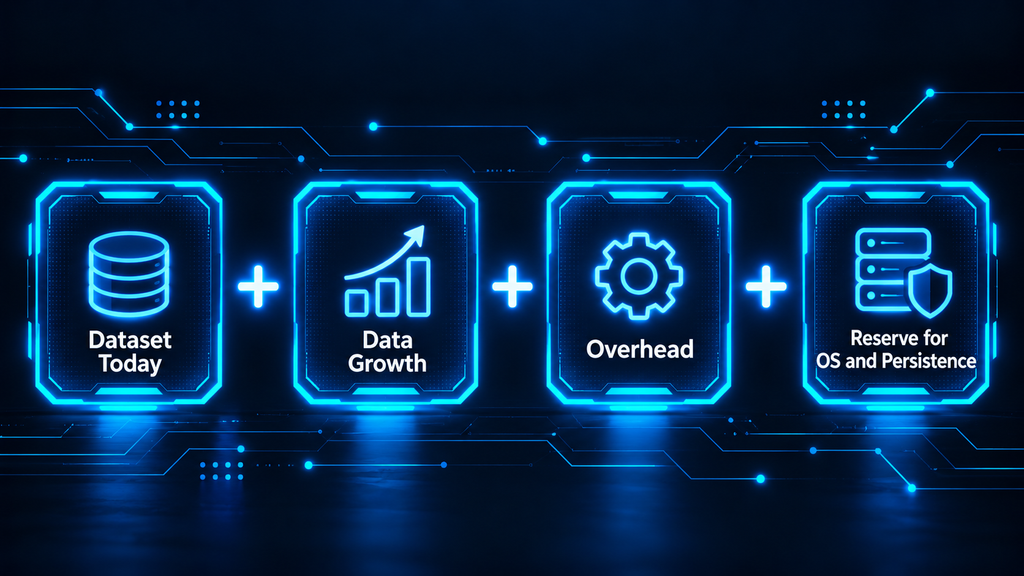
Точный лимит maxmemory мы рассчитаем позже отдельно.
Какую конфигурацию используем
Для нашего стенда возьмем:
- Ubuntu 24.04 LTS;
- Redis 8.x;
- 2 vCPU;
- 4 ГБ RAM;
- 40 ГБ SSD;
- один standalone Redis;
- systemd для управления сервисом.
Этого достаточно, чтобы:
- Проверить ACL;
- Протестировать
maxmemory; - Воспроизвести eviction;
- Включить RDB;
- Включить AOF;
- Выполнить restart и reboot;
- Проверить сохранность данных;
- Посмотреть поведение при нехватке памяти.
При этом мы специально не будем отдавать Redis все 4 ГБ.
Позже зададим maxmemory заметно ниже общего объема RAM и оставим запас системе.
Для ориентира:
| Ресурс | Минимальный тестовый VPS | Рекомендуемый небольшой сервер | Конфигурация статьи |
| CPU | 1 vCPU | 2+ vCPU | 2 vCPU |
| RAM | 1–2 ГБ | 4+ ГБ | 4 ГБ |
| Диск | 10–20 ГБ | 20–40+ ГБ SSD | 40 ГБ SSD |
| Swap | Только как страховка | Небольшой резерв | Проверим отдельно |
| Назначение | Lab / тесты | Небольшой кеш или service | Практический стенд |
Минимальный вариант годится для тестов, но для рабочего Redis лучше иметь запас по RAM. Именно он дает пространство для роста данных, фоновых операций и persistence.
Команды проверки VPS
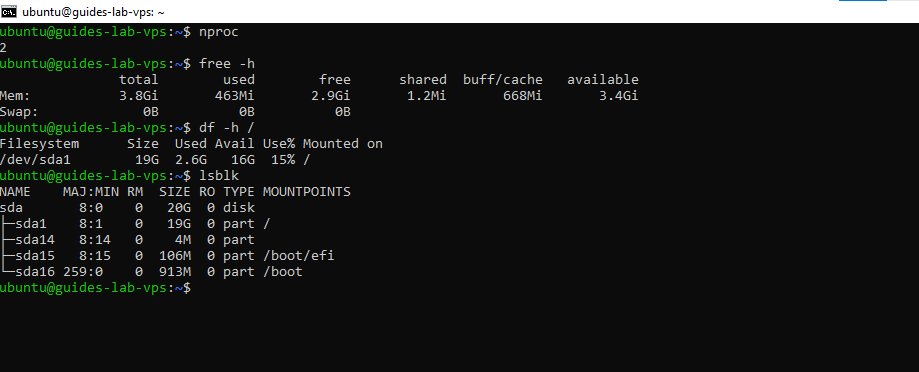
Перед установкой посмотрим, что за сервер нам выдали.
Версия Ubuntu:
lsb_release -aили:
cat /etc/os-releaseКоличество CPU:
nprocБолее подробная информация:
lscpuТеперь RAM:
free -hОсобенно смотрим на:
    total
available
Swap:
swapon --showДиски:
lsblkСвободное место:
df -hТакже полезно заранее проверить текущую нагрузку:
uptimeИ основные процессы:
ps aux --sort=-%mem | headЭто поможет понять, сколько RAM уже используется системой до установки Redis.
Основные команды можно оставить в коротком справочнике:
| Что проверяем | Зачем | Команда |
| Ubuntu | Проверить версию ОС | lsb_release -a |
| CPU | Посмотреть доступные процессоры | nproc |
| RAM | Проверить общий и свободный объем | free -h |
| Swap | Увидеть виртуальную память | swapon --show |
| Disk | Проверить устройства | lsblk |
| Свободное место | Оценить запас под RDB/AOF | df -h |
| Текущую нагрузку | Понять состояние VPS до Redis | uptime |
Теперь мы понимаем, какие ресурсы доступны Redis и какой запас останется для операционной системы. Следующий шаг — установить Redis на Ubuntu, запустить service и проверить первый ответ PONG.
Устанавливаем Redis на Ubuntu
Какой способ установки используем
Для Ubuntu удобнее всего использовать пакетную установку через apt.
Так Redis устанавливается как обычный системный сервис, получает стандартный конфигурационный файл и автоматически интегрируется с systemd. Это проще и надежнее, чем собирать Redis вручную из исходников для обычного VPS.
В базовом варианте установка выглядит так:
    sudo apt update
sudo apt install -y redis-server
После этого Redis уже можно запускать как сервис.
Какие компоненты устанавливаются
Основной пакет:
redis-serverОн содержит сам сервер Redis и служебные файлы для его запуска.
Для работы из командной строки нам также понадобится:
redis-cliЧерез него будем:
- Отправлять
PING; - Читать и записывать keys;
- Проверять authentication;
- Смотреть INFO;
- Читать CONFIG;
- Тестировать persistence и eviction.
Проверить версии можно так:
    redis-server --version
redis-cli --version
Так мы сразу убеждаемся, что и сервер, и клиент установлены.
Как работает сервис Redis
После установки Redis управляется через systemd.
Состояние сервиса:
sudo systemctl status redis-serverКороткая проверка:
sudo systemctl is-active redis-serverОжидаемый результат:
activeЧтобы Redis автоматически запускался после reboot:
sudo systemctl enable redis-serverОсновные команды управления:
    sudo systemctl start redis-server
sudo systemctl stop redis-server
sudo systemctl restart redis-server
Если сервис не запускается после изменения конфигурации, первым делом стоит посмотреть systemd logs:
sudo journalctl -u redis-server -n 100 --no-pagerПозже эта команда особенно пригодится после правок redis.conf.
Где находятся конфигурация, данные и логи
Основной конфигурационный файл Redis обычно находится здесь:
/etc/redis/redis.confИменно в нем дальше будем настраивать:
bind;protected-mode;- ACL;
maxmemory;maxmemory-policy;- RDB;
- AOF.
Рабочий каталог с persistence-файлами обычно находится в:
/var/lib/redisЗдесь могут храниться RDB snapshot и AOF-файлы.
Логи в пакетной установке могут идти через systemd journal, а при файловом логировании путь задается параметром logfile в redis.conf.
Проверить его можно так:
grep "^logfile" /etc/redis/redis.confДля диагностики через systemd:
sudo journalctl -u redis-serverТо есть основные точки проверки такие:
    /etc/redis/redis.conf
/var/lib/redis
systemd journal
Далее переходим к нашей любимой практике.
Практика: устанавливаем и запускаем Redis
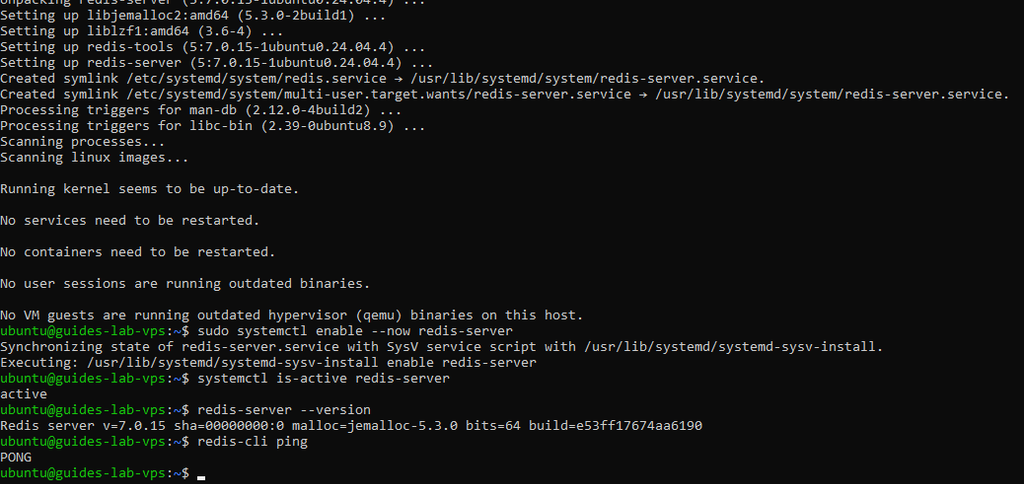
Сначала обновим индекс пакетов:
sudo apt updateУстанавливаем Redis:
sudo apt install -y redis-serverПроверяем версию:
redis-server --versionИ клиент:
redis-cli --versionТеперь запускаем Redis:
sudo systemctl start redis-serverВключаем автозапуск:
sudo systemctl enable redis-serverПроверяем состояние:
sudo systemctl status redis-serverДля короткой проверки:
sudo systemctl is-active redis-serverЕсли все в порядке, переходим к самому Redis.
Выполняем:
redis-cli pingОжидаемый ответ:
PONGЭто значит, что redis-cli смог подключиться к локальному Redis и сервер корректно обработал команду.
Можно дополнительно открыть интерактивную консоль:
redis-cliИ внутри выполнить:
PINGОтвет снова должен быть:
PONGВыйти можно командой:
QUITОсновные команды на этом этапе:
| Задача | Команда |
| Установить Redis | sudo apt install -y redis-server |
| Запустить сервис | sudo systemctl start redis-server |
| Включить автозапуск | sudo systemctl enable redis-server |
| Проверить состояние | sudo systemctl status redis-server |
| Проверить Redis | redis-cli ping |
| Посмотреть логи | sudo journalctl -u redis-server -n 100 --no-pager |
| Открыть конфигурацию | sudo nano /etc/redis/redis.conf |
На этом базовая установка готова: Redis запущен, systemd его контролирует, а redis-cli успешно подключается локально.
Разбираемся с базовыми настройками безопасности Redis
Redis уже установлен и отвечает на PING, но оставлять его в состоянии «запустили и забыли» не стоит. Следующий шаг — ограничить сетевую доступность и понять, на каких interfaces сервис вообще должен принимать подключения.
У Redis очень простой сетевой интерфейс, поэтому ошибка в bind или firewall может быстро превратить локальный сервис в доступный извне. Лучше сразу настроить сеть так, чтобы Redis был виден только тем узлам, которым он действительно нужен.
Почему Redis нельзя бездумно открывать в интернет
Redis не предназначен для того, чтобы просто слушать 6379 на всех interfaces и принимать подключения от любого клиента.
Если порт доступен из интернета, появляется сразу несколько рисков:
- Попытки подбора credentials;
- Сканирование и автоматические атаки;
- Лишняя нагрузка;
- Риск эксплуатации ошибки в ACL;
- Опасность случайно оставить слишком широкие права.
Даже если authentication уже настроена, открывать Redis всем подряд все равно нет смысла.
Правильнее строить доступ в несколько слоев:
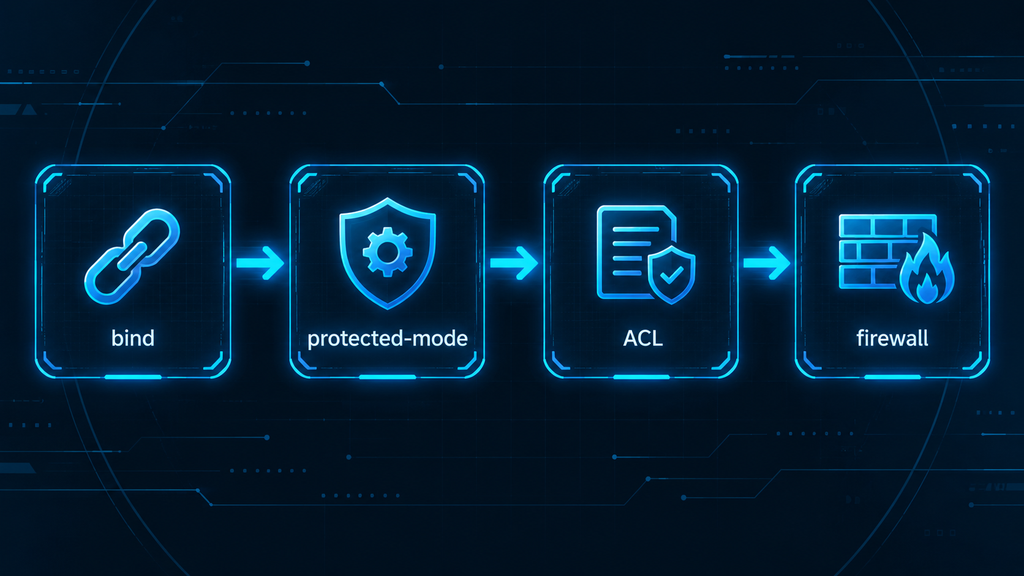
Каждый слой решает свою задачу, и вместе они дают более предсказуемую схему.
Как работает bind
Параметр bind определяет, на каких local interfaces Redis слушает подключения.
Например:
bind 127.0.0.1означает, что Redis доступен только с самого VPS.
Если нужно слушать еще и private interface сервера:
bind 127.0.0.1 10.0.0.10Теперь Redis принимает соединения:
- Через localhost;
- Через private IP 10.0.0.10.
Важно не путать это с фильтрацией клиентов.
bind не задает список разрешенных source IP. Он определяет только адреса самого сервера, на которых Redis принимает соединения.
Ограничение конкретных клиентов делается уже firewall.
Зачем нужен protected-mode
protected-mode — дополнительная страховка от слишком открытой конфигурации.
В базовом варианте:
protected-mode yesоставлять его включенным разумно.
Он помогает не допустить очевидно небезопасный сценарий, когда Redis оказывается доступен на внешнем interface без нормальной защиты, пропуская беспарольный доступ только с локальных интерфейсов.
Но воспринимать protected-mode как полноценную замену ACL или firewall не стоит.
Лучше считать его еще одним защитным слоем: protected-mode ≠ ACL ≠ firewall
Все три механизма решают разные задачи.
Как ограничить сетевой доступ
Если приложение работает на другом сервере, одного bind недостаточно.
Предположим:
Redis VPS: 10.0.0.10
Application VPS: 10.0.0.20
В redis.conf можно оставить:
    bind 127.0.0.1 10.0.0.10
protected-mode yes
port 6379
Теперь Redis слушает private interface.
Но дополнительно стоит ограничить порт через UFW:
sudo ufw allow from 10.0.0.20 to any port 6379 proto tcpПроверяем:
sudo ufw status numberedПри этом не нужно без необходимости делать:
sudo ufw allow 6379/tcpТакое правило откроет порт всем источникам.
Если у облачного провайдера есть отдельный network firewall или security group, ограничение лучше повторить и там.
Получается:
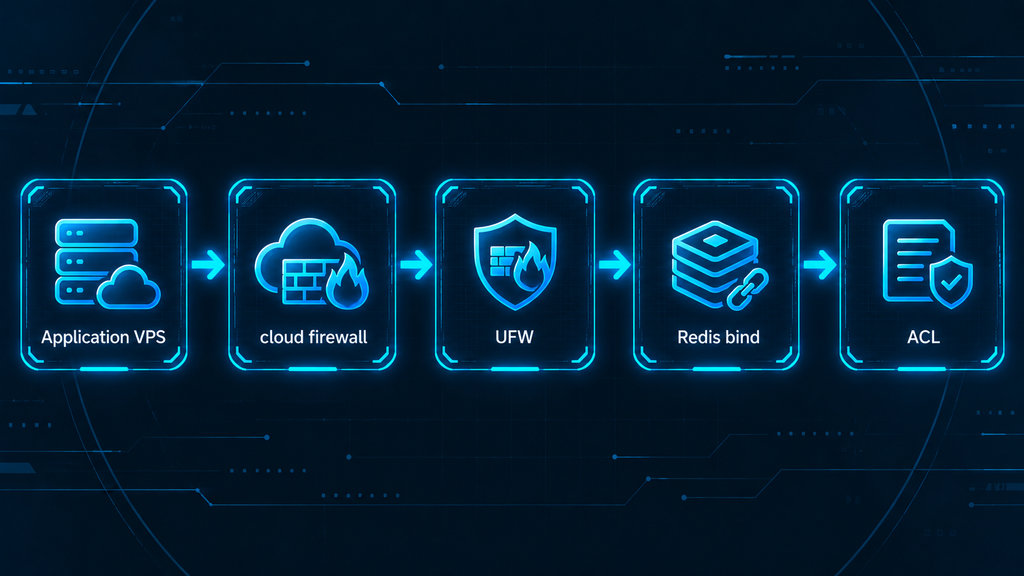
Идём дальше.
Когда достаточно localhost
Если приложение и Redis находятся на одном VPS, лучший вариант обычно самый простой:
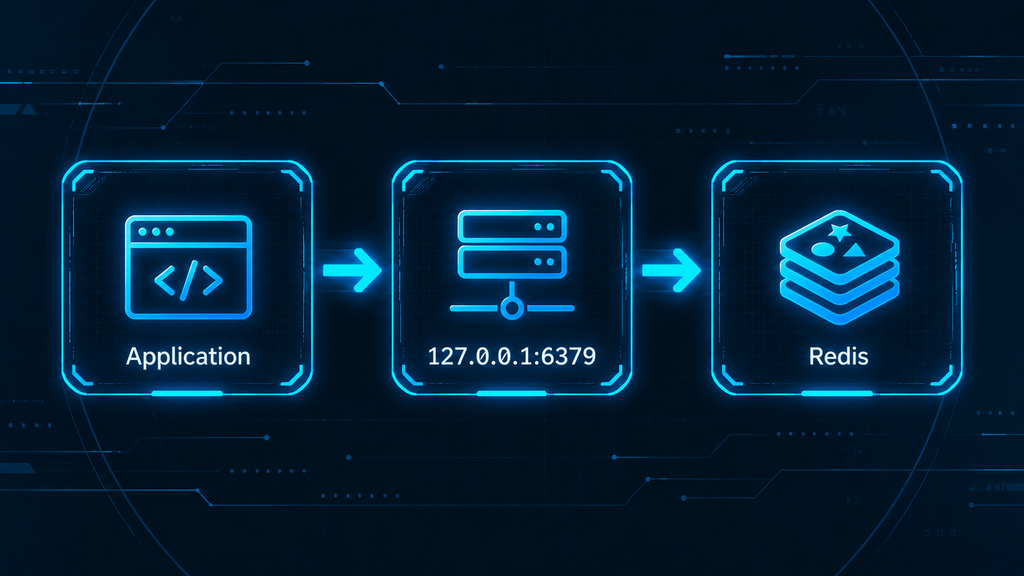
В этом случае redis.conf можно оставить с:
    bind 127.0.0.1
protected-mode yes
И внешний порт вообще не понадобится.
Так меньше:
- Сетевых правил;
- Маршрутов;
- Точек отказа;
- Поводов для неправильной настройки.
Если нет конкретной причины подключаться к Redis удаленно, localhost вполне достаточно.
Практика: оставляем Redis доступным только там, где нужно
Сначала откроем конфигурацию:
sudo nano /etc/redis/redis.confДля локальной схемы оставим:
    bind 127.0.0.1
protected-mode yes
port 6379
Сохраняем файл и перезапускаем Redis:
sudo systemctl restart redis-serverПроверяем, что сервис запустился:
sudo systemctl is-active redis-serverТеперь смотрим, где он слушает:
sudo ss -lntp | grep 6379Для localhost ожидаем адрес:
127.0.0.1:6379Если нужен private network, конфигурация может выглядеть так:
    bind 127.0.0.1 10.0.0.10
protected-mode yes
port 6379
После restart снова проверяем:
sudo ss -lntp | grep 6379Теперь должны увидеть и localhost, и private IP.
С Application VPS можно проверить сам TCP-порт:
nc -vz 10.0.0.10 6379Если соединение проходит, следующий уровень проверки — уже authentication и ACL.
Коротко варианты можно сравнить так:
| Сценарий | bind | Firewall | Когда использовать |
| Localhost | 127.0.0.1 | 6379 наружу закрыт | Приложение и Redis на одном VPS |
| Private network | 127.0.0.1 10.0.0.10 | Разрешен только IP приложения | Лучший вариант для разных VPS в одной private network |
| Public network | Localhost + нужный public interface | Только доверенный public IP | Только если private network архитектурно недоступна |
На этом сетевой контур готов: Redis слушает только нужные interfaces, а firewall дополнительно ограничивает источник подключения.
Следующий шаг — настроить authentication и ACL, чтобы даже клиент, который добрался до 6379, не получал доступ без правильной учетной записи и разрешенных команд.
Настраиваем аутентификацию Redis
Почему одного firewall недостаточно
Firewall решает сетевую задачу: он определяет, кто вообще может добраться до порта 6379.
Но после того как соединение установлено, Redis должен понимать, что именно разрешено этому клиенту.
Без authentication и ACL (не стоит путать этот ACL с облачным, тут речь именно про внутренний механизм Redis) любой разрешенный сетевой клиент может получить слишком широкие возможности.
Например, приложение может случайно выполнить административную команду или получить доступ к ключам, которые ему не нужны.
Поэтому нормальная схема выглядит так:
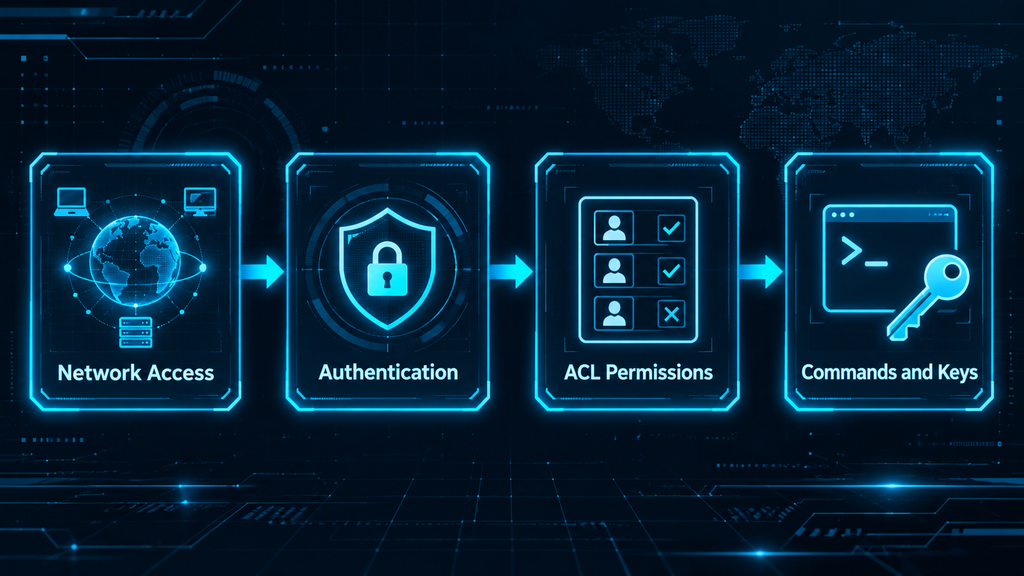
Firewall ограничивает источник подключения, а ACL ограничивает действия уже внутри Redis.
Как работает ACL
ACL в Redis строится вокруг пользователей.
Для каждого пользователя можно определить:
- Включен ли он вообще;
- Какой пароль используется;
- К каким keys есть доступ;
- Какие команды разрешены;
- Какие команды запрещены.
Например, можно создать пользователя приложения, который имеет доступ только к ключам с префиксом:
app:*и только к обычным операциям чтения и записи.
Условно:
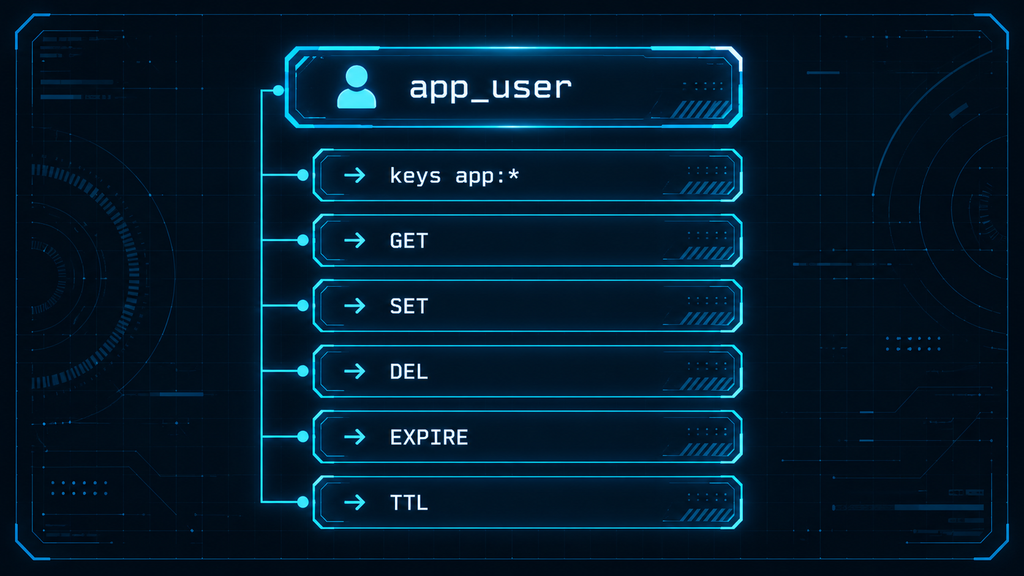
При этом административные команды ему не нужны.
Это удобнее, чем давать приложению полный доступ ко всему Redis.
Почему приложение не должно использовать default user без ограничений
В Redis существует default user.
Если оставить его включенным без нормальных ограничений, приложение может получить слишком широкие права. Особенно плохо, если одновременно используется простая схема с одним общим password и без разделения пользователей.
Намного лучше создать отдельного пользователя приложения и явно задать ему нужные permissions.
Например:
app_userбудет использоваться только приложением.
А default user можно либо отключить, либо оставить только для ограниченного сценария администрирования, если он действительно нужен.
По итогу выходит так:
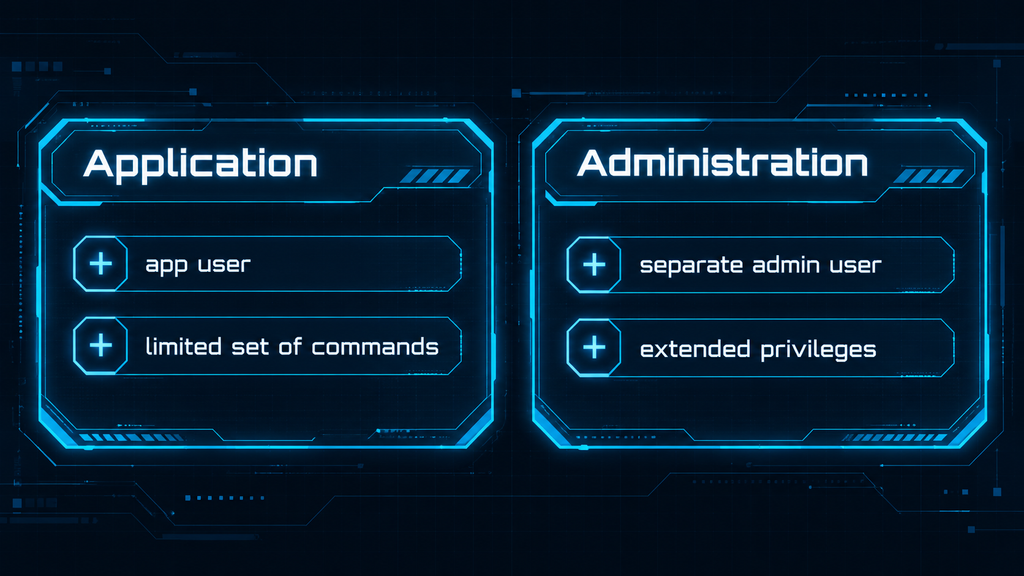
Далее переходим к командам.
Какие команды нужны приложению
Точный набор зависит от того, как именно Redis используется.
Для обычного кеша приложению часто нужны:
GET;SET;DEL;EXPIRE;TTL;MGET;MSET;- EXISTS.
Если используются counters:
INCR;- DECR.
Если работают lists, sets или hashes, набор команд расширяется.
Например:
    HGET
HSET
LPUSH
RPOP
SADD
SMEMBERS
Но нет смысла заранее открывать все Redis commands просто «на всякий случай».
Чем меньше разрешений, тем проще контролировать последствия ошибки приложения.
Практика: создаем отдельного пользователя
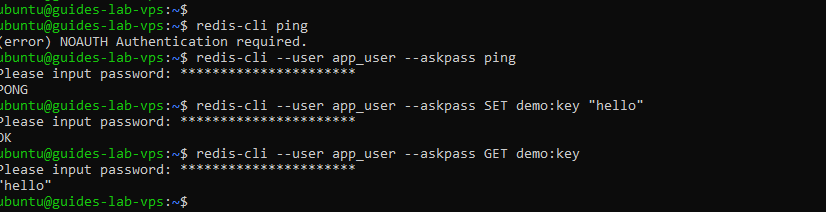
Откроем конфигурацию Redis:
sudo nano /etc/redis/redis.confДля примера создадим пользователя:
app_userс отдельным паролем, доступом только к ключам:
app:*и ограниченным набором команд.
Строка ACL может выглядеть так:
user app_user on >StrongPassword123 ~app:* +get +set +del +expire +ttl +exists +mget +msetРазберем ее:
app_user— имя пользователя;- on — пользователь включен;
- >
StrongPassword123— пароль; - ~
app:*— доступ только к keys с префиксом app:; - +get, +set и остальные — разрешенные команды.
В production пароль, конечно, должен быть случайным и значительно сильнее примера.
После изменения конфигурации перезапускаем Redis:
sudo systemctl restart redis-serverПроверяем сервис:
sudo systemctl is-active redis-serverТеперь попробуем выполнить команду без authentication:
redis-cli GET app:testЕсли authentication обязательна, Redis должен отказать в доступе.
Теперь подключимся под app_user:
    redis-cli \
  --user app_user \
  --pass StrongPassword123
После подключения создадим ключ:
SET app:test "hello"Ожидаем:
OKПроверим чтение:
GET app:testОжидаемый результат:
"hello"Теперь проверим ограничение по key pattern.
Попробуем создать ключ без префикса app::
SET other:test "blocked"Redis должен отказать в операции, потому что этот key не соответствует:
~app:*Можно проверить и запрещенную административную команду:
CONFIG GET maxmemoryЕсли мы ее не разрешали, Redis должен вернуть ошибку ACL.
Так мы сразу подтверждаем две вещи:
- Пользователь успешно аутентифицируется;
- Его permissions действительно ограничены.
Теперь authentication и ACL настроены: приложение подключается под отдельным пользователем, работает только с нужными keys и не получает административный доступ.
Следующий шаг — проверить connection string, локальное и удаленное подключение, а также поведение Redis при неправильном пароле и запрещенной ACL-команде.
Проверяем подключение к Redis
Здесь удобно сразу разделять три уровня: сеть → authentication → permissions. Если TCP-соединение не устанавливается, до пароля дело еще не дошло. Если Redis отвечает ошибкой authentication — сеть работает, но credentials неверны. А если login проходит, но отдельная команда запрещена, проблема уже в ACL.
Как выглядит connection string
Для Redis можно использовать URI вида:
redis://username:password@host:6379Для локального подключения нашего приложения строка будет выглядеть примерно так:
redis://app_user:password@127.0.0.1:6379Если используется отдельная logical database Redis, можно добавить ее номер:
redis://app_user:password@127.0.0.1:6379/0Здесь:
app_user— ACL-пользователь;- password — его пароль;
127.0.0.1— адрес Redis;- 6379 — порт;
/0— номер logical database.
В реальном приложении пароль лучше хранить в environment variables или secret storage, а не прописывать прямо в коде или shell-командах.
Теперь проверим самый простой сценарий — локальное подключение.
Как проверить локальное подключение
На самом Redis VPS можно подключиться так:
    redis-cli \
  --user app_user \
  --pass StrongPassword123
Если credentials правильные, Redis CLI откроется без ошибки.
Проверим соединение:
PINGОжидаем:
PONGТеперь проверим доступ к разрешенному key pattern:
SET app:connection-test "ok"Ответ:
OKИ чтение:
GET app:connection-testОжидаем:
"ok"Получается, локально мы уже подтвердили сразу несколько вещей: redis-server работает, authentication проходит, ACL-пользователь активен, а разрешенные команды выполняются.
Следующий уровень — тот же тест, но с другого сервера.
Как проверить удаленное подключение
Если Redis и приложение находятся на разных VPS, сначала проверяем сам TCP-порт.
С Application VPS:
nc -vz 10.0.0.10 6379Если соединение проходит, можно переходить к Redis CLI:
    redis-cli \
  -h 10.0.0.10 \
  -p 6379 \
  --user app_user \
  --pass StrongPassword123
Проверяем:
PINGОжидаем:
PONGИ еще раз читаем разрешенный key:
GET app:connection-testЕсли локально Redis работает, но nc с другого VPS не соединяется, проблема находится еще до authentication. Тогда нужно возвращаться к bind, UFW, cloud firewall или private network.
Если же nc проходит, а Redis возвращает ошибку login, сетевой уровень уже можно считать рабочим.
Дальше специально проверим такой сценарий.
Что происходит при неверном пароле
Попробуем подключиться с правильным username, но неправильным password:
    redis-cli \
  --user app_user \
  --pass WrongPassword
Redis должен отказать в authentication.
Ошибка будет указывать, что username/password pair не прошла проверку.
Это полезно тем, что сразу отделяет проблему credentials от сетевой ошибки.
Условно:
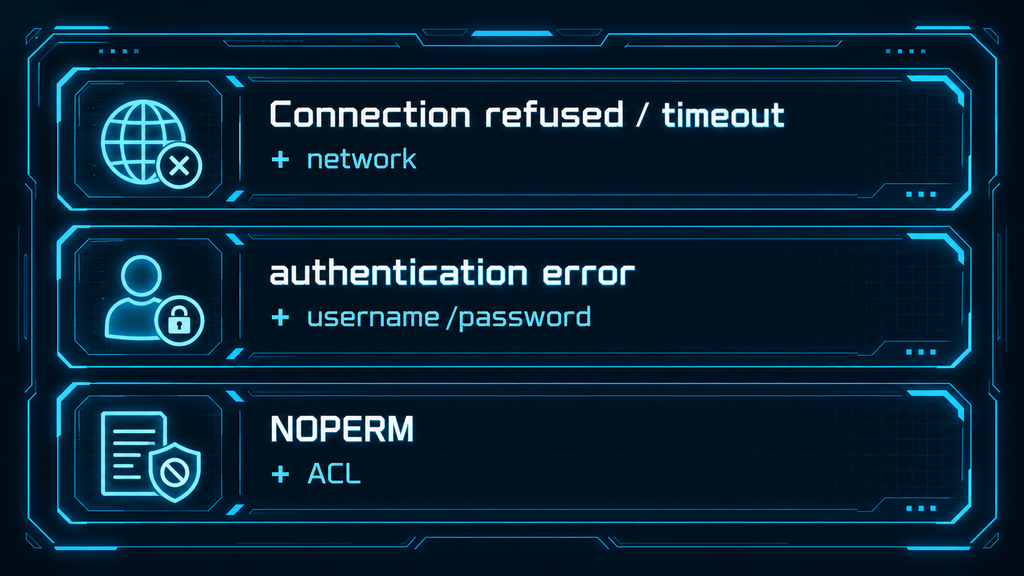
Если пароль кажется правильным, стоит проверить еще и имя пользователя. В Redis ACL username имеет значение: пароль от одного пользователя не даст доступ под другим.
После проверки неправильного password возвращаем правильные credentials и переходим к следующему уровню — permissions.
Что происходит при запрещенной ACL-команде
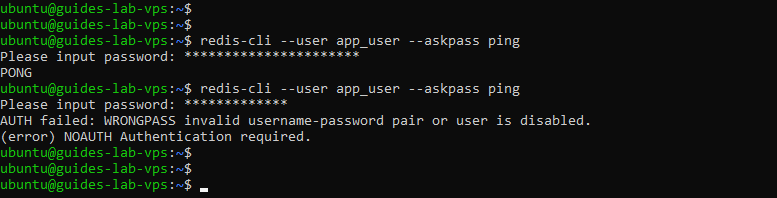
Подключимся снова под app_user:
    redis-cli \
  --user app_user \
  --pass StrongPassword123
Обычная операция должна работать:
GET app:connection-testТеперь попробуем административную команду, которую пользователю не разрешали:
CONFIG GET maxmemoryRedis должен вернуть ошибку ACL вида NOPERM.
То же самое произойдет, если попытаться обратиться к key вне разрешенного pattern:
SET other:test "blocked"Поскольку пользователь ограничен:
~app:*такой key должен быть запрещен.
Это уже не ошибка authentication. Пользователь вошел успешно, но Redis блокирует конкретное действие.
На практике различие очень полезное:
- Login не проходит → проверяем credentials;
- Login проходит, но команда запрещена → проверяем ACL;
- Соединения нет вообще → проверяем сеть.
Основные сценарии можно свести в короткую таблицу:
| Сценарий | Команда | Ожидаемый результат |
| Локальное подключение | redis-cli --user app_user --pass ... | Успешный вход |
| Удаленное подключение | redis-cli -h 10.0.0.10 --user app_user --pass ... | Успешный вход |
| Проверка соединения | PING | PONG |
| Неверный пароль | Login с неправильным password | Ошибка authentication |
| Запрещенная команда | CONFIG GET maxmemory | NOPERM |
| Запрещенный key | SET other:test ... | NOPERM |
| Недоступный порт | nc -vz 10.0.0.10 6379 | Ошибка соединения или timeout |
Теперь подключение проверено на всех основных уровнях: сеть, authentication и ACL работают независимо друг от друга и дают понятные ошибки.
Разбираемся, как Redis использует память
Теперь можно перейти к тому, что для Redis критично почти в любом сценарии, — к памяти.
Redis хранит рабочий набор данных в RAM, поэтому поведение сервера при росте dataset напрямую зависит от того, сколько памяти доступно и задан ли maxmemory. Если этот момент не настроить заранее, Redis может начать конкурировать за RAM с операционной системой, использовать swap или вовсе упереться в системный OOM.
Почему Redis в первую очередь хранит данные в RAM
Главное преимущество Redis — очень быстрый доступ к данным. Для этого keys и values находятся в оперативной памяти, а не читаются с диска при каждом запросе.
Даже если включены RDB или AOF, persistence не превращает Redis в обычную disk-based database. Эти механизмы нужны прежде всего для восстановления данных после restart или сбоя, а текущая работа все равно идет с набором, который Redis держит в памяти.
Из этого следует важное ограничение: объем данных нельзя оценивать только по размеру SSD. Сервер может иметь сотни гигабайт свободного места на диске, но если Redis должен держать 6 ГБ dataset при 4 ГБ RAM, сам по себе большой диск проблему не решит.
Поэтому дальше будем ориентироваться прежде всего на RAM, а диск рассматривать отдельно — как место для RDB, AOF и системных файлов.
Что входит в потребление памяти
Количество памяти, которое Redis использует в реальности, почти всегда больше простого размера values.
В RAM находятся:
- Сами keys;
- Values;
- Структуры данных Redis;
- Metadata;
- Allocator overhead;
- Client buffers;
- Служебные структуры;
- Память для replication, если она используется;
- Временный overhead при некоторых фоновых операциях.
Например, тысяча маленьких строковых values не занимает ровно сумму их полезных данных. Для каждого key и объекта нужны дополнительные структуры, а memory allocator тоже имеет собственные накладные расходы.
Поэтому полезно различать: размер полезных данных ≠ фактическое потребление памяти Redis
Кроме того, при RDB snapshot или AOF rewrite Redis может создавать дочерний процесс через fork(). В этот момент работает copy-on-write: пока страницы памяти не меняются, они могут использоваться совместно, но активная запись во время фоновой операции способна заметно увеличить фактическое потребление RAM.
Именно поэтому позже при расчете maxmemory мы оставим запас, а не выставим лимит почти равным всей оперативной памяти VPS.
Как посмотреть текущую память Redis
Основная команда диагностики:
redis-cli INFO memoryЕсли включена ACL:
    redis-cli \
  --user app_user \
  --pass StrongPassword123 \
  INFO memory
Но для технического мониторинга лучше использовать пользователя, которому разрешена команда INFO.
В выводе нас будут интересовать несколько показателей.
Например:
    used_memory:1048576
used_memory_human:1.00M
used_memory_rss:7340032
used_memory_peak_human:1.20M
maxmemory:2147483648
maxmemory_human:2.00G
mem_fragmentation_ratio:1.15
used_memory показывает объем памяти, выделенный Redis через allocator.
Более удобный для чтения вариант:
used_memory_humanused_memory_rss показывает, сколько физической памяти процесс Redis занимает с точки зрения операционной системы.
Эти значения могут отличаться. RSS включает особенности allocator, fragmentation и фактически отображенные memory pages, поэтому он не обязан совпадать с used_memory.
Пиковое потребление можно посмотреть через:
used_memory_peakили:
used_memory_peak_humanЭто пригодится, если Redis сейчас использует немного RAM, но ранее нагрузка была значительно выше.
Когда текущая память понятна, можно переходить к главному ограничителю — maxmemory.
Что такое maxmemory
maxmemory задает объем памяти, после достижения которого Redis начинает применять настроенную maxmemory-policy.
Например:
maxmemory 2gbможно задать в:
/etc/redis/redis.confТекущую настройку можно посмотреть так:
redis-cli CONFIG GET maxmemoryРезультат будет примерно таким:
    1) "maxmemory"
2) "2147483648"
Redis показывает значение в bytes.
То, что произойдет после достижения этого лимита, зависит уже от:
maxmemory-policyНапример, Redis может:
- Удалять старые keys;
- Удалять редко используемые keys;
- Выбирать keys с
TTL; - Вообще перестать принимать операции записи.
Этот механизм позволяет заранее определить поведение сервера при заполнении памяти вместо того, чтобы ждать, пока закончится RAM на всем VPS.
Именно поэтому maxmemory и maxmemory-policy почти всегда нужно рассматривать вместе.
Что произойдет, если лимит не задан
Если maxmemory не настроен, Redis не получает собственного жесткого ограничения памяти и может продолжать расти вместе с dataset.
Тогда пределом становится уже RAM самого VPS.
Например:
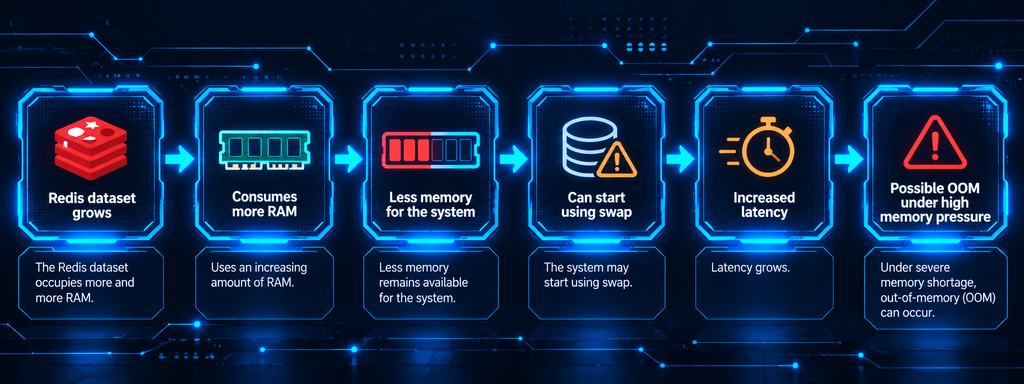
Для кеша такое поведение особенно бессмысленно: вместо того чтобы вытеснить несколько старых keys, Redis может начать давить на всю систему.
Если же Redis используется как важное хранилище и автоматическое удаление данных недопустимо, лимит все равно полезен — просто вместе с ним можно выбрать noeviction. Тогда Redis не начнет незаметно удалять keys, а новые записи при нехватке памяти будут завершаться ошибкой.
То есть maxmemory нужен не только для кеша. Он задает границу, после которой Redis начинает действовать по заранее выбранному сценарию.
Ключевые показатели INFO memory можно свести в короткую таблицу:
| Метрика | Что показывает | На что смотреть |
used_memory | Память, выделенная Redis | Текущее потребление |
used_memory_human | То же значение в удобном формате | Быстрая ручная проверка |
used_memory_rss | Фактический RSS процесса | Сравнивать с used_memory |
used_memory_peak | Максимальное потребление с момента запуска | Искать прошлые пики |
maxmemory | Настроенный лимит Redis | Не должен съедать всю RAM VPS |
mem_fragmentation_ratio | Соотношение RSS и используемой памяти | Помогает заметить fragmentation |
Теперь понятно, почему для Redis недостаточно просто смотреть на общий объем RAM VPS. Нужно отдельно определить, сколько памяти разрешено самому Redis и какой запас оставить системе и persistence.
Следующий наш шаг — как раз рассчитать maxmemory на конкретном примере с 4 ГБ RAM и задать лимит так, чтобы Redis не работал вплотную к физической памяти сервера.
Рассчитываем лимит maxmemory
Почему нельзя отдавать Redis всю RAM VPS
Предположим, на VPS установлено:
4 ГБ RAM
Если задать:
maxmemory 4gbRedis получит право занять практически всю память сервера под свои данные.
Но кроме dataset существуют:
- Операционная система;
- Page cache;
- Системные процессы;
- Client buffers;
- Allocator overhead;
- Memory fragmentation;
- Fork при RDB или AOF rewrite;
- Другие сервисы на VPS.
Поэтому такая конфигурация быстро оставляет систему без запаса.
В результате возможна неприятная цепочка:
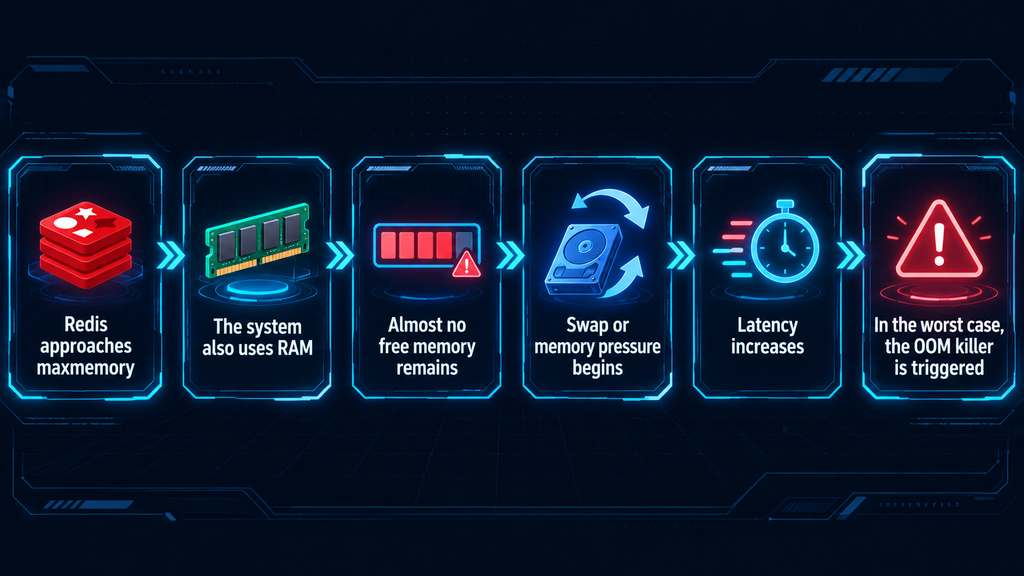
Поэтому maxmemory — это не «вся RAM Redis-сервера», а только та часть памяти, которую мы сознательно разрешаем Redis использовать под рабочие данные.
Сколько памяти оставить операционной системе
Универсального процента здесь нет.
На маленьком VPS разумно оставить заметный запас, особенно если Redis работает не один. Для сервера с 4 ГБ RAM можно ориентироваться примерно на:
1 ГБ
под Ubuntu и системные процессы.
Но это не жесткое правило.
Если на том же сервере работают:
- Nginx;
- приложение;
- monitoring agent;
- Docker;
- другие databases;
запас придется увеличить.
Поэтому сначала полезно посмотреть реальное потребление системы:
free -hи:
ps aux --sort=-%mem | headЕсли чистая система уже использует, например, 700–900 МБ RAM, оставлять ей всего 300 МБ сверху было бы слишком агрессивно.
После системного резерва нужно учесть еще один важный фактор — persistence.
Как учитывать persistence и fork
При RDB snapshot и некоторых операциях с AOF Redis использует fork().
Основной процесс продолжает работать, а дочерний занимается созданием snapshot или rewrite.
Сразу после fork() память не удваивается полностью благодаря copy-on-write. Но если в этот момент приложение активно изменяет данные, измененные memory pages начинают копироваться.
Поэтому во время фоновой операции потребление RAM может заметно вырасти.
Условно:
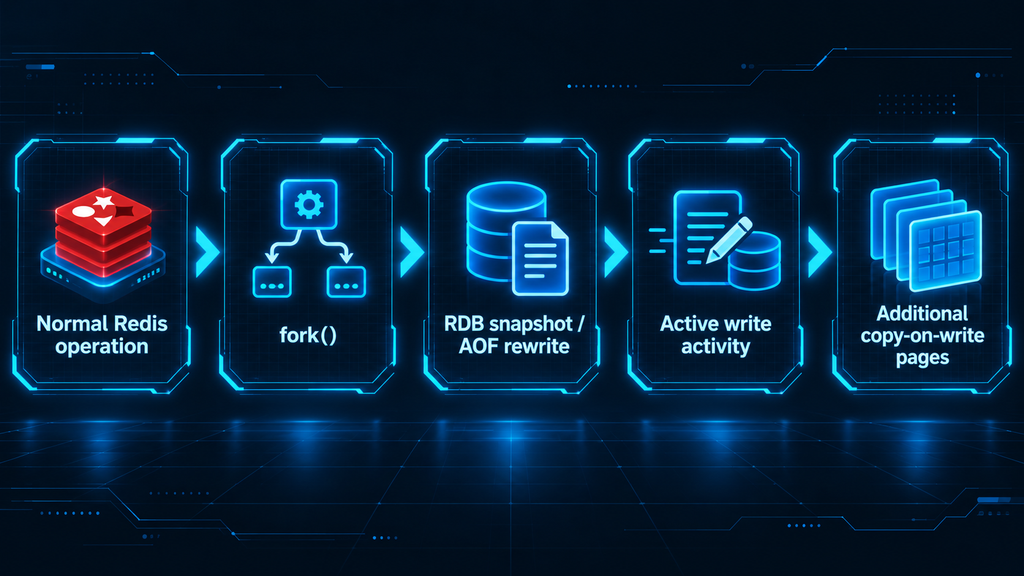
Чем больше dataset и интенсивнее запись, тем важнее запас.
Поэтому для Redis с persistence нельзя считать:
RAM VPS - память ОС = maxmemory
Нужно оставить еще резерв именно под фоновые операции.
Для небольшого VPS это особенно важно, потому что несколько сотен мегабайт дополнительного расхода уже могут заметно повлиять на систему.
Пример расчета для VPS с 4 ГБ RAM
Возьмем нашу конфигурацию:
VPS: 4 ГБ RAM
Сначала оставим примерно:
1 ГБ
операционной системе и системным процессам.
Остается:
3 ГБ
Теперь оставим еще примерно:
1 ГБ
под persistence, fork, fragmentation и непредвиденный рост.
Получаем:
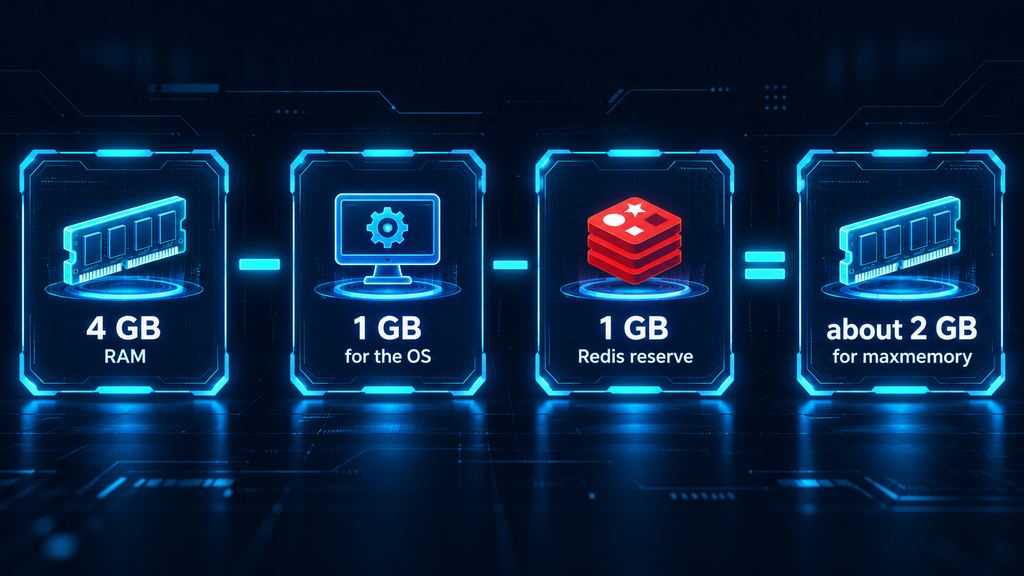
То есть рабочая отправная точка:
maxmemory 2gbЭто довольно консервативная конфигурация, но для небольшого VPS она дает хороший запас.
Важно понимать: это не универсальная формула.
Если Redis используется только как кеш без persistence и сервер почти пустой, лимит можно поднять выше.
Если же dataset большой, запись интенсивная, включены RDB и AOF, а рядом работает приложение, наоборот, потребуется больше резерва.
Поэтому реальная настройка строится так:
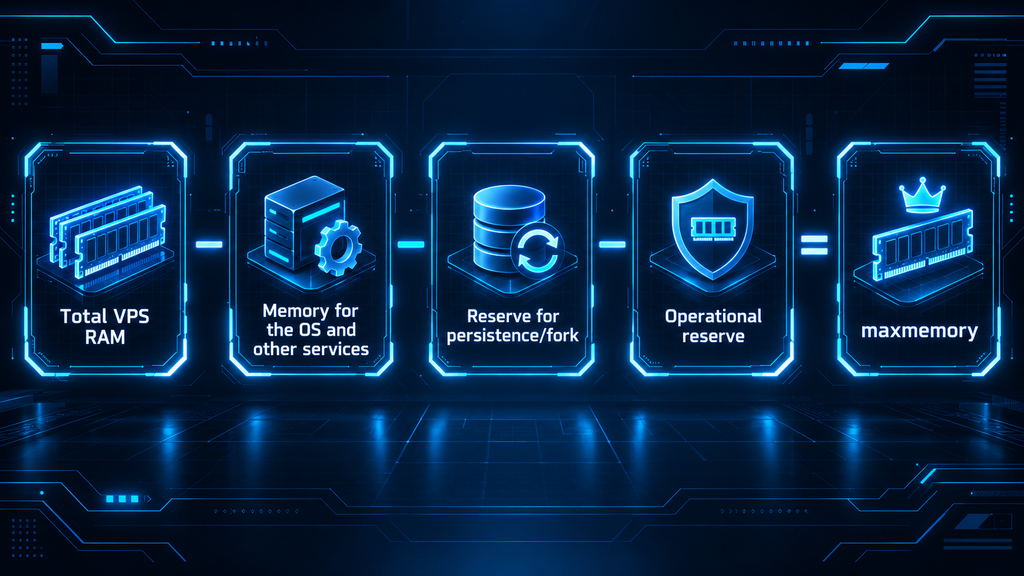
Далее переходим к практике.
Практика: задаем maxmemory
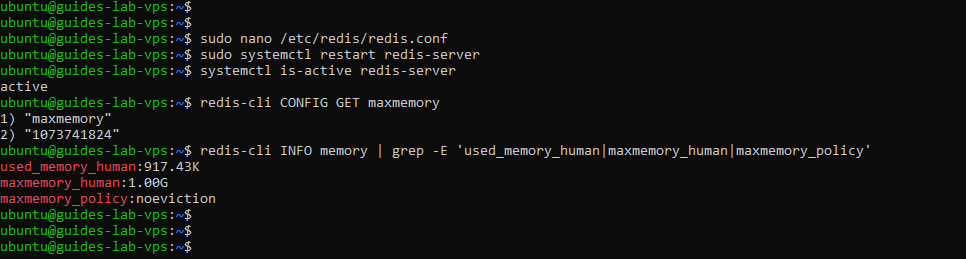
Откроем конфигурацию:
sudo nano /etc/redis/redis.confНайдем или добавим:
maxmemory 2gbРядом можно сразу оставить текущую eviction policy, например:
maxmemory-policy noevictionПока используем noeviction, чтобы Redis не удалял keys автоматически до того, как отдельно разберем разные политики.
Фрагмент конфигурации:
    maxmemory 2gb
maxmemory-policy noeviction
Сохраняем файл и перезапускаем Redis:
sudo systemctl restart redis-serverПроверяем сервис:
sudo systemctl is-active redis-serverТеперь смотрим, применился ли лимит:
redis-cli CONFIG GET maxmemoryОжидаем значение около:
2147483648Это 2 ГБ в bytes.
Проверим policy:
redis-cli CONFIG GET maxmemory-policyОжидаем:
noevictionТеперь посмотрим память:
redis-cli INFO memoryОсобенно интересуют:
    used_memory
used_memory_human
used_memory_rss
maxmemory
maxmemory_human
Для более компактной проверки можно использовать:
redis-cli INFO memory | grep -E "used_memory_human|maxmemory_human"Условный результат:
    used_memory_human:1.10M
maxmemory_human:2.00G
То есть Redis сейчас использует немного RAM, но уже знает предел, после которого начнет действовать по выбранной policy.
Теперь у Redis есть четкая граница по памяти. Он больше не сможет бесконтрольно расти до размера всей RAM VPS.
Выбираем политику удаления ключей
Далее Redis должен понимать, что делать, когда используемая память подойдет к этому пределу.
За это отвечает:
maxmemory-policyИменно здесь определяется поведение Redis при нехватке памяти: отказать в новых записях или начать освобождать место за счет существующих keys.
Что происходит при достижении maxmemory
Когда Redis упирается в заданный лимит, он смотрит на maxmemory-policy.
Дальше возможны два принципиально разных сценария.
Первый:
noevictionRedis ничего не удаляет автоматически и начинает отклонять операции, которым нужна дополнительная память.
Второй вариант — eviction. Тогда Redis выбирает подходящие keys и удаляет их, чтобы освободить место для новых данных.
Получается так:
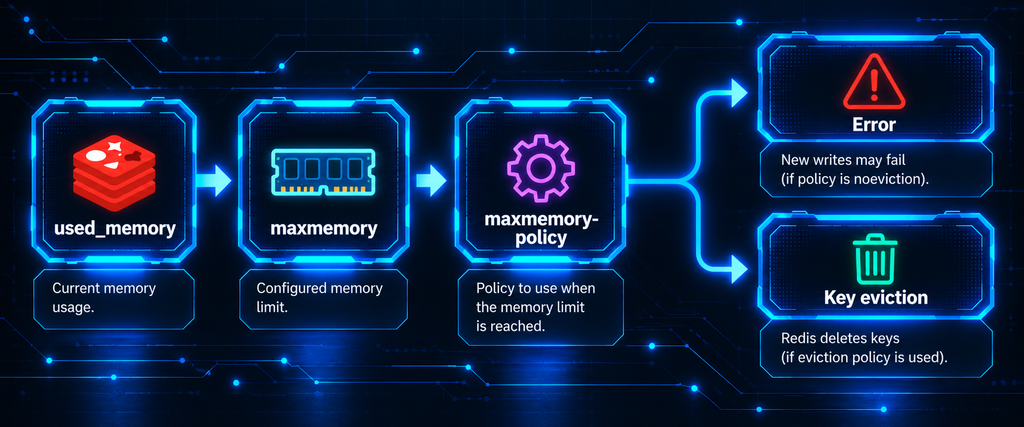
Поэтому policy всегда нужно подбирать под роль Redis. Для кеша автоматическое вытеснение часто полезно, а для важных данных — может быть опасным.
Чем noeviction отличается от eviction
noeviction — самый осторожный вариант с точки зрения сохранности существующих данных.
При нем Redis не начинает удалять keys сам.
Если памяти больше нет, команда записи может завершиться ошибкой вроде:
OOM command not allowed when used memory > 'maxmemory'При этом чтение существующих данных продолжает работать.
Такой режим хорошо подходит там, где автоматическая потеря keys недопустима.
Eviction policies работают иначе: Redis освобождает память, удаляя часть уже существующих данных.
Это удобно для кеша, потому что старый key можно удалить и при необходимости получить заново из основного источника.
То есть:
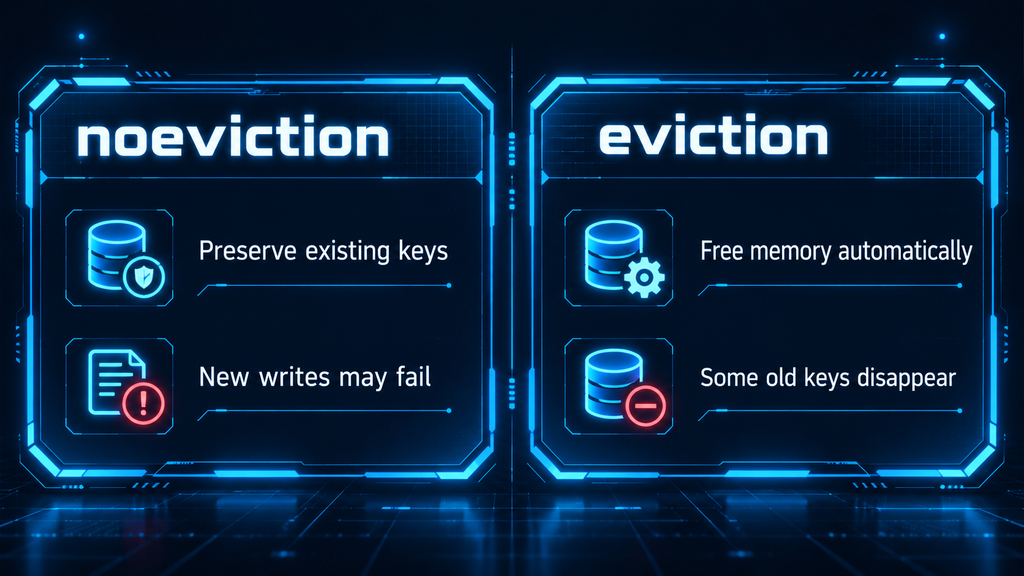
Дальше важно понять, по какому принципу выбираются keys для удаления.
Как работают LRU, LFU и TTL-политики
Redis поддерживает несколько стратегий.
LRU — Least Recently Used.
Идея простая: в первую очередь удаляются keys, к которым давно не обращались.
Например:
- key A → использовался только что
- key B → 10 минут назад
- key C → час назад
При нехватке памяти Redis скорее выберет key C.
Есть две основные LRU-политики:
    allkeys-lru
volatile-lru
allkeys-lru рассматривает все keys.
volatile-lru — только keys с установленным TTL.
LFU — Least Frequently Used.
Здесь Redis ориентируется не на давность последнего обращения, а на частоту использования.
Условно:
- key A → читают постоянно
- key B → иногда
- key C → почти никогда
При eviction первым кандидатом становится key C.
Соответствующие policies:
    allkeys-lfu
volatile-lfu
Для кеша LFU иногда подходит даже лучше LRU, если есть небольшой набор постоянно "горячих" данных, которые важно удерживать в памяти.
Есть и TTL-ориентированный вариант:
volatile-ttlОн выбирает среди keys с expiration и старается удалять те, у которых TTL ближе к завершению.
Также существуют random-политики:
    allkeys-random
volatile-random
Они удаляют keys случайно и обычно используются реже, потому что LRU/LFU дают более осмысленное поведение.
Как выбрать policy для кеша
Если Redis используется как обычный кеш, автоматическое вытеснение — нормальная часть работы.
Чаще всего можно смотреть в сторону:
allkeys-lruили:
allkeys-lfuallkeys-lru хорошо подходит для сценария, где свежие данные обычно важнее давно неиспользуемых.
allkeys-lfu — если хочется дольше удерживать часто запрашиваемые keys.
Если кеш устроен так, что только часть keys временная и имеет TTL, можно использовать volatile-*.
Но здесь есть важный нюанс: если memory заполнится keys без TTL, volatile-* не сможет вытеснять их.
Поэтому для классического кеша часто проще и понятнее использовать allkeys-*.
Как выбрать policy для хранилища
Если Redis хранит данные, которые нельзя потерять автоматически, eviction уже становится рискованным.
В таком случае обычно логичнее:
maxmemory-policy noevictionТогда Redis не будет сам удалять существующие keys.
Да, при заполнении памяти новые записи начнут падать, но это лучше, чем незаметное удаление данных.
Такой режим заставляет проблему проявиться явно:
OOMи дает администратору возможность:
- Увеличить RAM;
- Поднять
maxmemory; - Удалить ненужные данные вручную;
- Исправить
TTL; - Переработать модель хранения.
Для важного state это обычно безопаснее.
Если Redis используется в смешанном режиме — часть keys критична, часть временная — лучше не полагаться только на одну общую eviction policy. Надежнее заранее разделить типы данных или хотя бы строить TTL и keyspace так, чтобы поведение было предсказуемым.
Практика: настраиваем maxmemory-policy
Откроем конфигурацию:
sudo nano /etc/redis/redis.confДля обычного кеша можно задать:
    maxmemory 2gb
maxmemory-policy allkeys-lru
Или:
    maxmemory 2gb
maxmemory-policy allkeys-lfu
Если Redis используется как хранилище:
    maxmemory 2gb
maxmemory-policy noeviction
Сохраняем файл и перезапускаем Redis:
sudo systemctl restart redis-serverПроверяем сервис:
sudo systemctl is-active redis-serverТеперь смотрим текущую policy:
redis-cli CONFIG GET maxmemory-policyНапример:
    1) "maxmemory-policy"
2) "allkeys-lru"
И еще раз проверяем лимит:
redis-cli CONFIG GET maxmemoryТак мы убеждаемся, что Redis знает и границу памяти, и правило поведения после ее достижения.
Дальше идёт таблица:
| Policy | Что удаляется | Где использовать | Основной риск |
noeviction | Ничего | Важные данные, storage-like сценарий | Новые записи начинают падать |
allkeys-lru | Давно неиспользуемые keys | Обычный кеш | Могут удаляться любые keys |
allkeys-lfu | Редко используемые keys | Кеш с выраженными hot keys | Могут удаляться любые keys |
volatile-lru | Давно неиспользуемые keys с TTL | Кеш, где только временные keys можно удалять | Keys без TTL не участвуют в eviction |
volatile-lfu | Редко используемые keys с TTL | Аналогично, но с учетом частоты | Та же зависимость от TTL |
volatile-ttl | Keys с ближайшим expiration | Временные данные с корректным TTL | Не затрагивает keys без TTL |
allkeys-random | Случайные keys | Редкие специальные сценарии | Непредсказуемое вытеснение |
volatile-random | Случайные keys с TTL | Редкие специальные сценарии | Зависит от наличия TTL |
Если Redis используется как кеш, обычно разумно начинать с allkeys-lru или allkeys-lfu. Если данные нельзя удалять автоматически — с noeviction.
Проверяем eviction на практике
Политику вытеснения мы уже выбрали, но теперь важно увидеть ее не только в конфигурации. Создадим контролируемый тест: временно уменьшим maxmemory, заполним Redis тестовыми keys и посмотрим, что происходит при приближении к лимиту.
Для такого эксперимента удобнее не пытаться забить все 2 ГБ RAM. На время проверки поставим небольшой лимит, например 32 МБ, а после теста вернем рабочее значение.
Заполняем Redis тестовыми ключами
Сначала посмотрим текущие настройки:
    redis-cli CONFIG GET maxmemory
redis-cli CONFIG GET maxmemory-policy
Для теста временно зададим:
    redis-cli CONFIG SET maxmemory 32mb
redis-cli CONFIG SET maxmemory-policy allkeys-lru
Проверяем:
    redis-cli CONFIG GET maxmemory
redis-cli CONFIG GET maxmemory-policy
Теперь будем создавать тестовые keys с достаточно крупными values, чтобы память заполнялась заметно быстрее.
Один из простых вариантов — использовать цикл:
    payload=$(head -c 2048 /dev/zero | tr '\0' 'A')
for i in $(seq 1 50000); do
  redis-cli SET "eviction:test:$i" "$payload" > /dev/null
done
Каждый value здесь содержит примерно 2 КБ данных.
Количество реально сохранившихся keys можно проверить:
redis-cli DBSIZEНо сам по себе DBSIZE еще не показывает, началось ли вытеснение. Для этого нужно параллельно следить за памятью и statistics.
Как увидеть приближение к maxmemory
Во время заполнения Redis можно периодически выполнять:
redis-cli INFO memoryДля более компактного вывода:
redis-cli INFO memory | grep -E "used_memory_human|maxmemory_human"Например, сначала можно увидеть:
    used_memory_human:8.42M
maxmemory_human:32.00M
Позже:
    used_memory_human:24.73M
maxmemory_human:32.00M
А затем значение будет приближаться к заданному лимиту.
Текущий maxmemory можно отдельно проверить:
redis-cli CONFIG GET maxmemoryВажно помнить, что used_memory не обязан остановиться ровно на красивой отметке 32.00M. Redis учитывает служебную память и внутренние структуры, а процесс с точки зрения операционной системы может занимать больше.
Наша задача здесь другая — увидеть момент, когда Redis больше не может бесконечно принимать новые данные и начинает применять maxmemory-policy.
Что происходит после достижения лимита
При:
maxmemory-policy allkeys-lruRedis начинает освобождать память за счет существующих keys.
Новые SET продолжают выполняться, но часть старых записей постепенно исчезает.
Можно проверить один из ранних keys:
redis-cli GET eviction:test:1Если он уже был вытеснен, получим:
(nil)При этом более свежий key может все еще существовать:
redis-cli GET eviction:test:50000Но LRU не стоит воспринимать как строгую очередь «самый первый key удаляется первым». Redis оценивает давность использования и выбирает кандидатов на eviction, поэтому конкретный порядок удаления зависит от реальной активности keys.
Для сравнения можно временно включить:
redis-cli CONFIG SET maxmemory-policy noevictionи продолжить записи.
Когда памяти для новой операции уже недостаточно, Redis вместо автоматического удаления существующих keys начнет возвращать OOM-ошибку.
Таким образом, различие становится видно непосредственно на практике:
allkeys-lru→ старые keys вытесняются
→ новые записи продолжаются
noeviction→ существующие keys сохраняются
→ новые записи начинают завершаться ошибкой
После сравнения вернем allkeys-lru для текущего eviction-теста:
redis-cli CONFIG SET maxmemory-policy allkeys-lruТеперь осталось посмотреть, сколько keys Redis действительно вытеснил.
Как проверить число вытесненных ключей
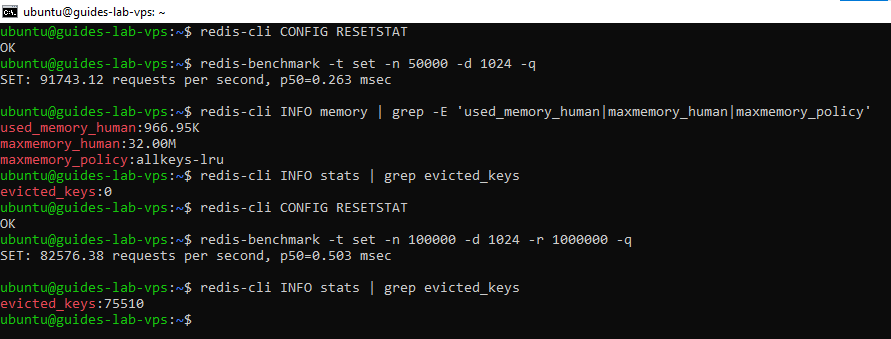
Статистика Redis доступна через:
redis-cli INFO statsНас интересует:
evicted_keysМожно вывести только его:
redis-cli INFO stats | grep evicted_keysДо теста значение может быть:
evicted_keys:0После заполнения памяти:
evicted_keys:8421Конкретное число зависит от размера values, текущего overhead и количества записей.
Полезно смотреть вместе две группы метрик:
    redis-cli INFO memory | grep -E "used_memory_human|maxmemory_human"
redis-cli INFO stats | grep evicted_keys
Первая показывает состояние памяти, вторая — фактическое количество eviction.
Можно дополнительно посмотреть число существующих keys:
redis-cli DBSIZEЕсли мы выполнили десятки тысяч SET, но DBSIZE перестал расти пропорционально количеству записей, а evicted_keys увеличивается, значит политика вытеснения действительно работает.
После теста важно вернуть рабочие настройки:
redis-cli CONFIG SET maxmemory 2gbИ проверить:
    redis-cli CONFIG GET maxmemory
redis-cli CONFIG GET maxmemory-policy
Если рабочая policy тоже должна быть allkeys-lru, оставляем ее. Если Redis в дальнейшем будет использоваться как хранилище, перед production вернем noeviction.
Также нужно помнить, что CONFIG SET меняет работающую конфигурацию, но наши постоянные параметры все равно должны быть зафиксированы в /etc/redis/redis.conf. Именно этот файл должен содержать рабочие maxmemory и maxmemory-policy, чтобы после следующего restart Redis вернулся с нужными настройками.
Теперь мы увидели реальное поведение Redis при заполнении памяти. Следующий вопрос уже другой: что произойдет не с отдельными keys при eviction, а со всем набором данных после restart. Для этого разберем persistence и сравним RDB с AOF.
Разбираемся с сохранением данных Redis
Почему данные в RAM не означают отсутствие persistence
Во время обычной работы Redis читает и изменяет данные в оперативной памяти. Именно поэтому он такой быстрый.
Но отдельно он может сохранять состояние на диск.
Условно:
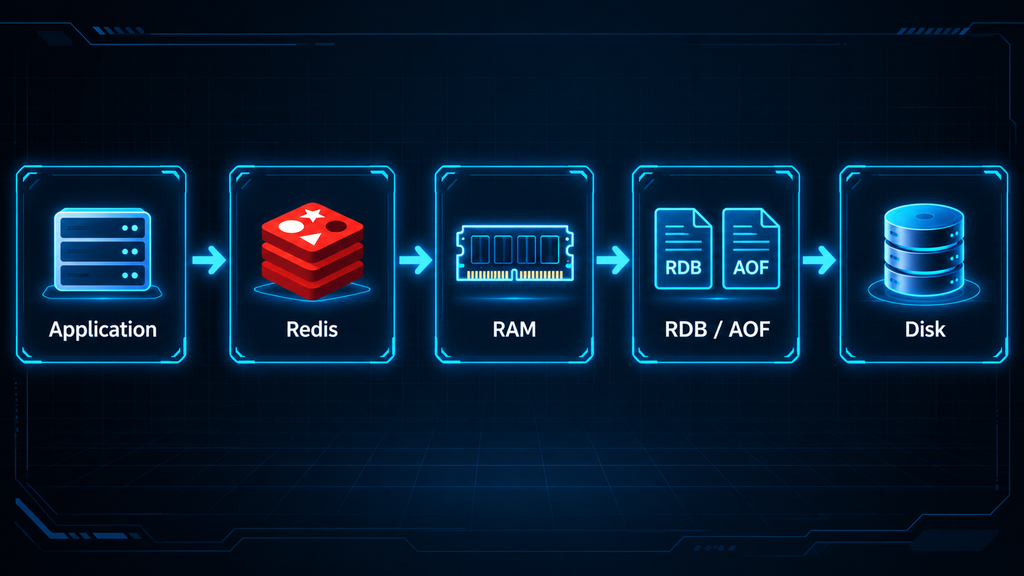
После restart Redis может прочитать persistence-файлы и восстановить keys обратно в память.
При этом важно разделять две вещи:
- Рабочие данные → RAM
- Восстановление после restart → RDB / AOF
То есть persistence не меняет основной принцип работы Redis. Диск здесь нужен не для каждого обычного чтения, а для восстановления состояния после перезапуска или сбоя.
Дальше разберем два основных механизма — RDB и AOF.
Как работает RDB
RDB создает snapshot состояния Redis на определенный момент времени.
Результатом становится файл вроде:
dump.rdbВ нем Redis хранит данные, которые существовали на момент создания snapshot.
Логика выглядит так:
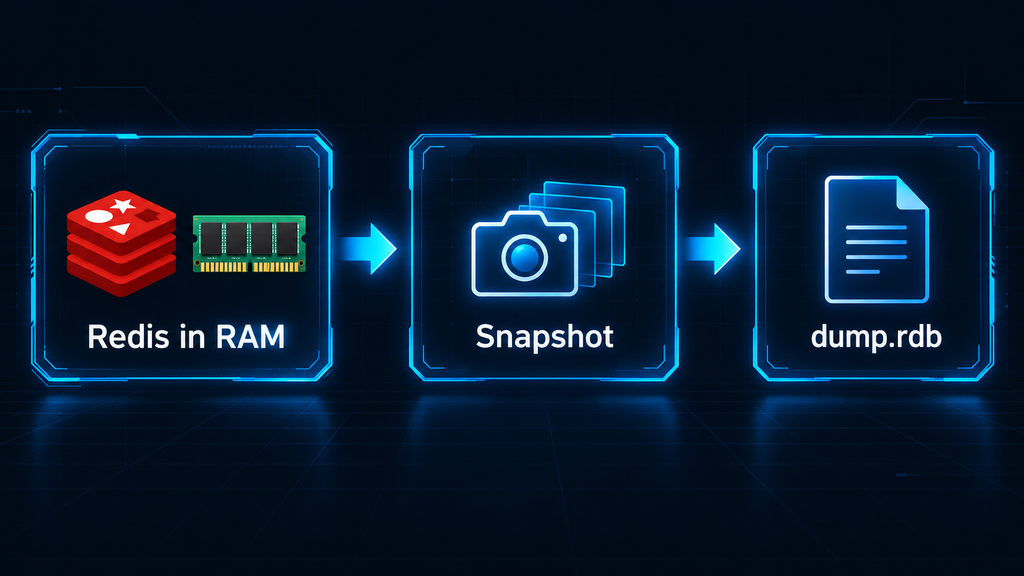
RDB можно создавать:
- Автоматически по заданным правилам;
- Вручную;
- Перед определенными операциями.
Главное преимущество RDB — компактный файл и достаточно простое восстановление.
Но snapshot создается периодически, а не после каждой записи. Поэтому при внезапном падении можно потерять изменения, сделанные после последнего успешного snapshot.
Например:
- 10:00 → RDB snapshot
- 10:01 →
SETkey1 - 10:02 →
SETkey2 - 10:03 → аварийное отключение
Если нового snapshot не было, последние изменения могут не попасть в dump.rdb.
Поэтому RDB хорошо подходит там, где допустима некоторая потеря последних записей или нужен периодический backup состояния.
Как работает AOF
AOF работает по другому принципу.
Вместо периодического snapshot Redis записывает операции, которые изменяют данные.
Условно:
    SET app:a 1
INCR app:counter
DEL app:old
попадают в append-only log.
После restart Redis может воспроизвести этот журнал и восстановить состояние.
Схема:
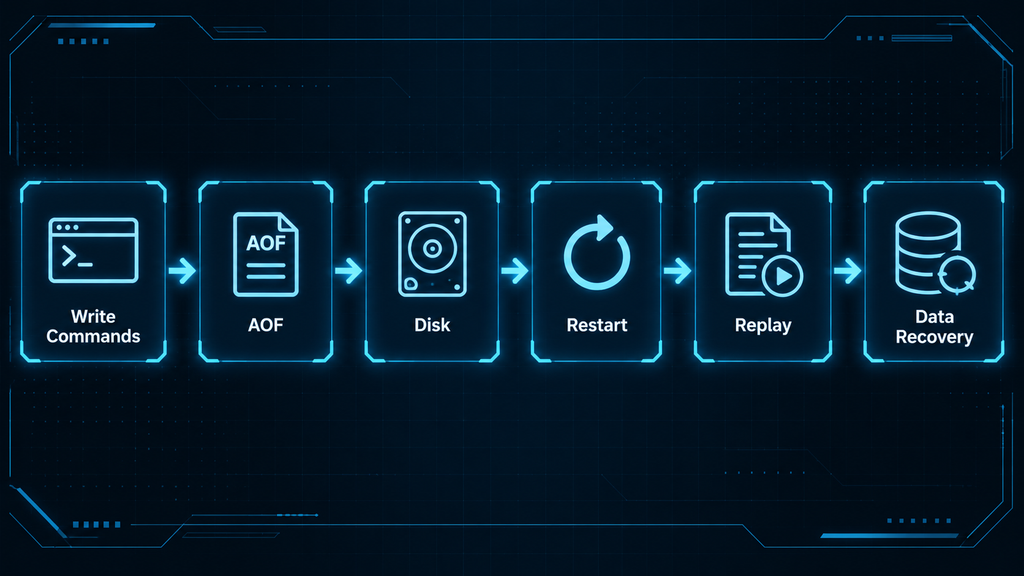
За то, как часто данные реально синхронизируются с диском, отвечает:
appendfsyncПозже отдельно разберем:
    always
everysec
no
Именно от этой настройки зависит баланс между надежностью и производительностью.
AOF обычно позволяет уменьшить возможную потерю последних изменений по сравнению с редкими RDB snapshots, но создает больше дисковой активности и требует периодического rewrite, чтобы журнал не рос бесконечно.
Можно ли использовать RDB и AOF одновременно
Да.
Redis может одновременно:
- создавать RDB snapshots;
- вести AOF.
Тогда оба механизма работают параллельно.
Это дает более гибкую схему:
- RDB → компактный snapshot
- AOF → более подробный журнал изменений
Но за это приходится платить дополнительной нагрузкой на диск и более сложной эксплуатацией.
Если оба механизма включены, при запуске Redis ориентируется на AOF как на более полное представление последних изменений.
Поэтому комбинация RDB+AOF подходит, если хочется иметь и snapshot, и журнал операций.
Для небольшого кеша это часто избыточно, а для более важных данных может быть вполне оправданно.
Когда persistence вообще не нужен
Если Redis используется исключительно как кеш, а данные всегда можно восстановить из основного источника, persistence можно отключить.
Например:
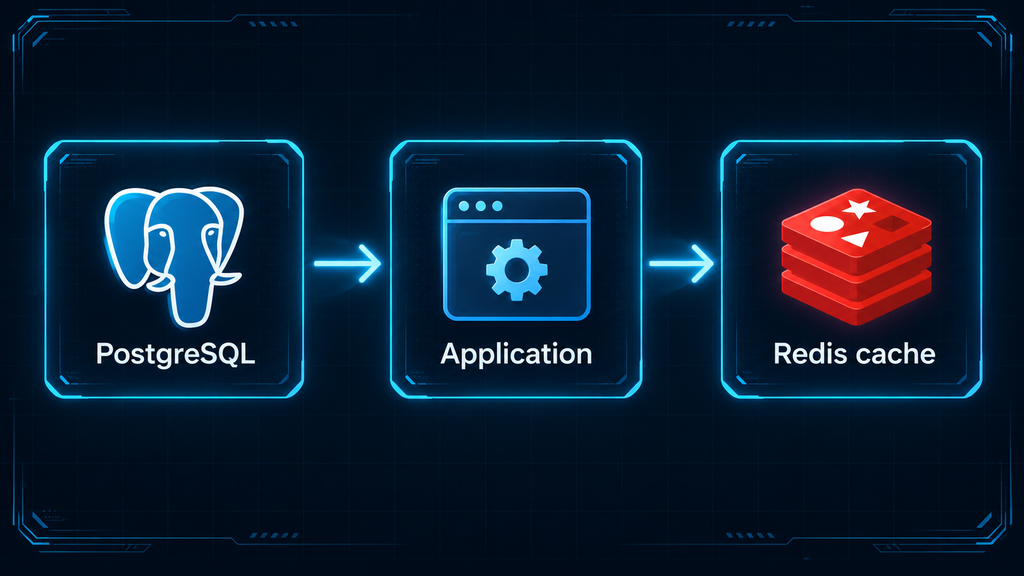
Если Redis перезапустится и очистится, приложение просто начнет заново наполнять кеш.
В таком сценарии persistence только:
- Создает дополнительную запись на диск;
- Увеличивает нагрузку;
- Усложняет конфигурацию.
А вот если Redis хранит:
- Важные counters;
- State;
- Очереди;
- Данные, которые нельзя просто пересоздать;
от persistence отказываться уже рискованно.
Основные варианты можно сравнить так:
| Режим | Что сохраняется | Потеря последних данных | Где использовать |
| Без persistence | Ничего | Все данные после restart | Чистый кеш |
| RDB | Периодические snapshots | Возможна потеря изменений после последнего snapshot | Кеш с восстановлением, backup, умеренно важные данные |
| AOF | Журнал операций записи | Зависит от appendfsync | Более важные и часто меняющиеся данные |
| RDB + AOF | Snapshot + журнал | Минимальная в рамках выбранного appendfsync | Когда важны и восстановление, и дополнительная страховка |
Теперь механизм сохранения понятен. Начнем с более простого варианта — RDB.
Настраиваем RDB
RDB хорошо подходит как первый persistence-механизм: он сравнительно простой, создает компактный snapshot и позволяет быстро проверить, переживают ли данные restart.
Сначала разберемся, когда этот режим действительно удобен, а затем включим его и посмотрим, где появляется dump.rdb.
Когда RDB подходит лучше всего
RDB особенно удобен в трех сценариях.
Первый — Redis используется преимущественно как кеш, но желательно не начинать после каждого restart наполнение полностью с нуля.
Второй — периодические snapshots нужны как дополнительная точка восстановления.
Третий — допустима потеря части последних изменений между snapshot.
То есть RDB хорошо вписывается туда, где важна простота и компактность, а абсолютная фиксация каждой отдельной операции не требуется.
Если же потеря нескольких последних секунд или минут записи недопустима, AOF обычно подходит лучше.
Как работают snapshot rules
Автоматические snapshots задаются через правила save.
Их логика строится вокруг двух параметров: время + число изменений
Например:
save 3600 1означает: создать snapshot, если за 3600 секунд изменился хотя бы один key.
Другой пример:
save 300 100создаст snapshot, если за 300 секунд произошло не менее 100 изменений.
Можно задать несколько правил одновременно.
Условно:
    save 3600 1
save 300 100
save 60 10000
Redis проверяет их независимо. Если выполняется хотя бы одно условие, запускается RDB snapshot.
Так можно сделать редкие snapshots при низкой активности и более частые — при интенсивной записи.
Где хранится dump
Расположение RDB определяется двумя параметрами:
    dir
dbfilename
Проверить их можно так:
    redis-cli CONFIG GET dir
redis-cli CONFIG GET dbfilename
Обычно получим что-то вроде:
    dir
/var/lib/redis
и:
    dbfilename
dump.rdb
Тогда полный путь:
/var/lib/redis/dump.rdbПроверить файл можно:
sudo ls -lh /var/lib/redis/dump.rdbЕсли snapshot еще ни разу не создавался, файла может пока не быть.
Теперь настроим RDB и создадим его вручную.
Практика: включаем и проверяем RDB
Открываем конфигурацию:
sudo nano /etc/redis/redis.confОставим несколько понятных правил:
    save 3600 1
save 300 100
save 60 10000
И убедимся, что RDB-файл называется:
dbfilename dump.rdbа рабочий каталог:
dir /var/lib/redisСохраняем конфигурацию и перезапускаем Redis:
sudo systemctl restart redis-serverПроверяем сервис:
sudo systemctl is-active redis-serverТеперь создадим контрольный key:
redis-cli SET app:rdb-test "saved-by-rdb"Если используется ACL-пользователь:
    redis-cli \
  --user app_user \
  --pass StrongPassword123 \
  SET app:rdb-test "saved-by-rdb"
Проверяем:
redis-cli GET app:rdb-testТеперь вручную запускаем snapshot:
redis-cli BGSAVEОжидаем ответ:
Background saving startedСтатус persistence можно посмотреть так:
redis-cli INFO persistenceНас интересуют, например:
    rdb_bgsave_in_progress
rdb_last_save_time
rdb_last_bgsave_status
После завершения:
    rdb_bgsave_in_progress:0
rdb_last_bgsave_status:ok
Теперь проверим файл:
sudo ls -lh /var/lib/redis/dump.rdbМожно дополнительно посмотреть время изменения:
sudo stat /var/lib/redis/dump.rdbЕсли dump.rdb существует и rdb_last_bgsave_status показывает ok, snapshot создан успешно.
На этом RDB работает: Redis умеет периодически сохранять состояние в dump.rdb, а при следующем запуске сможет использовать этот файл для восстановления данных.
Следующий шаг — настроить AOF и сравнить его с RDB уже на практике: как ведется журнал, чем отличаются always, everysec и no, и какой вариант лучше подходит для более важных данных.
Настраиваем AOF
Когда лучше использовать AOF
AOF имеет смысл, когда важнее уменьшить возможную потерю последних изменений.
Например, если Redis хранит:
- Counters;
- Очереди;
- Session state;
- Временное состояние workflow;
- Данные, которые не хочется терять между двумя RDB snapshots.
В такой схеме AOF обычно дает более предсказуемое восстановление после сбоя.
Но за это приходится платить дополнительной записью на диск и некоторым overhead.
То есть условно:
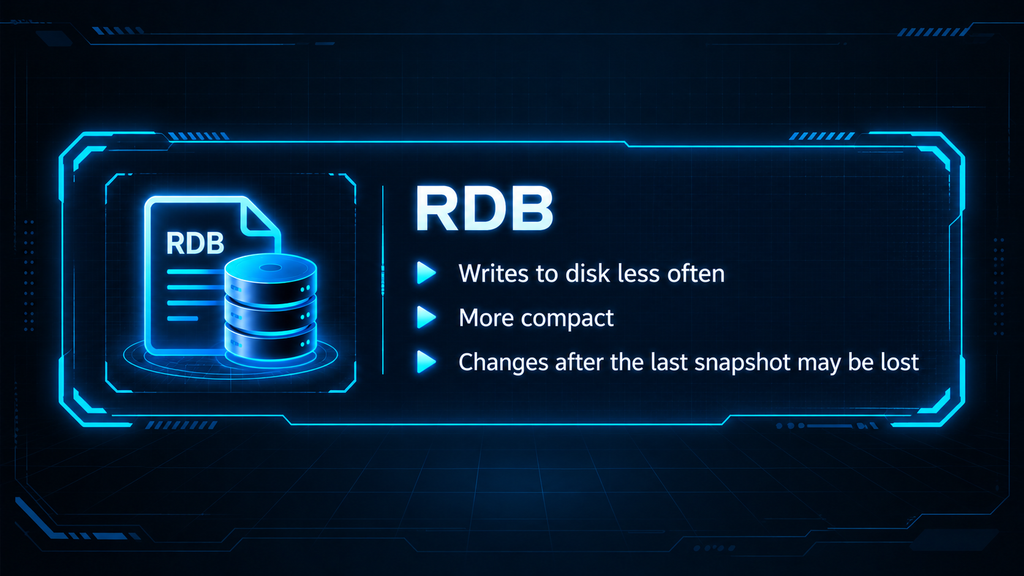
и
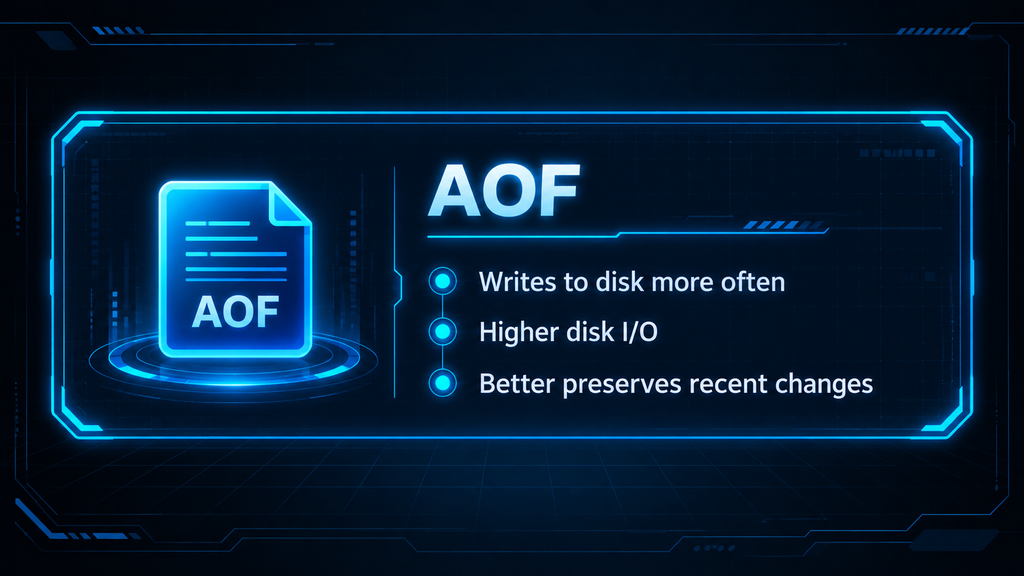
Теперь разберемся, как именно он работает.
Как работает appendonly
AOF включается параметром:
appendonly yesПосле этого Redis начинает записывать операции, которые изменяют данные.
Например:
    SET app:user:1 "Alice"
INCR app:counter
DEL app:old
Эти действия попадают в AOF.
При restart Redis читает журнал и воспроизводит команды, чтобы восстановить состояние.
Упрощенно:
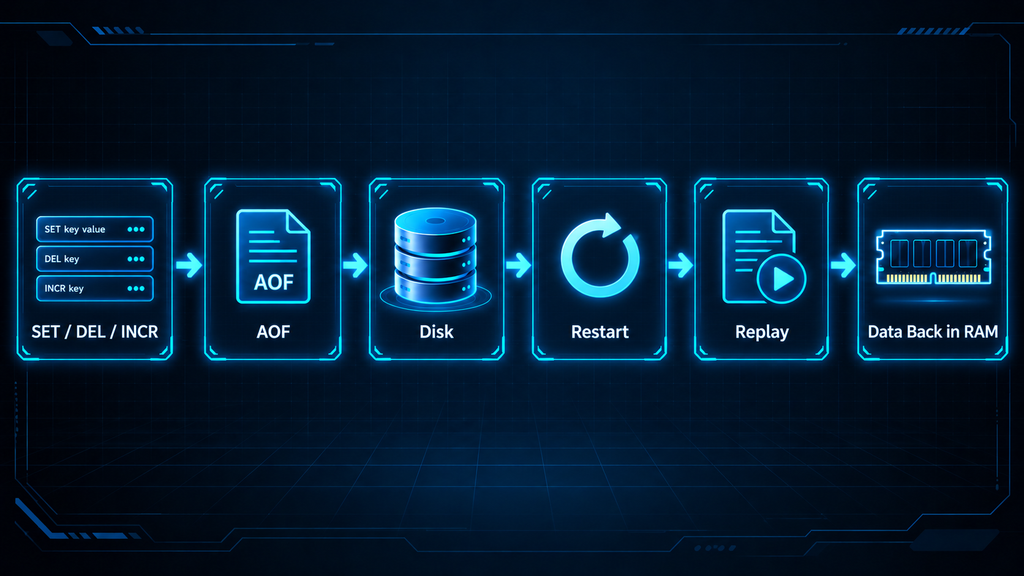
AOF при этом не должен бесконечно расти.
Redis периодически выполняет rewrite: формирует более компактное представление текущего состояния вместо хранения всей истории изменений.
Например, если значение одного key менялось сотни раз, в новом AOF нет необходимости хранить все промежуточные SET. Достаточно сохранить итоговое состояние.
Чем отличаются политики appendfsync
Сам параметр appendonly yes еще не определяет, насколько часто данные физически синхронизируются с диском.
За это отвечает:
appendfsyncЕсть три основных режима.
Первый:
appendfsync alwaysRedis запрашивает синхронизацию после каждой операции записи.
Это самый осторожный вариант с точки зрения потери последних данных, но и самый тяжелый для диска.
Второй:
appendfsync everysecСинхронизация обычно выполняется примерно раз в секунду.
Это хороший компромисс между надежностью и производительностью, поэтому для многих сценариев именно everysec выглядит наиболее сбалансированно.
Третий:
appendfsync noRedis сам не запрашивает fsync для каждой записи или каждую секунду, а полагается на операционную систему.
Производительность может быть выше, но момент фактической записи на диск становится менее предсказуемым.
Что выбрать между always, everysec и no
Для обычного VPS чаще всего разумно начинать с:
appendfsync everysecПри таком режиме возможная потеря последних изменений при аварии обычно ограничена небольшим интервалом, а диск не получает fsync после каждой отдельной команды.
always подойдет там, где потеря даже последних операций крайне нежелательна и storage способен выдержать дополнительную нагрузку.
no уместен, если производительность важнее гарантии быстрого сброса данных на диск.
Коротко:
appendfsync | Надежность | Производительность | Когда использовать |
always | Максимальная среди AOF-режимов | Ниже | Очень важные записи |
everysec | Высокая | Хороший баланс | Большинство production-сценариев |
no | Ниже | Выше | Когда допустима большая потеря последних изменений |
Теперь включим AOF на нашем сервере.
Практика: включаем AOF
Открываем:
sudo nano /etc/redis/redis.confНаходим или добавляем:
    appendonly yes
appendfsync everysec
Проверим также имя AOF:
appendfilename "appendonly.aof"В новых версиях Redis AOF может храниться не как один простой файл, а как набор файлов внутри отдельного каталога, включая base и incremental AOF. Поэтому лучше смотреть фактическое расположение через текущую конфигурацию и содержимое рабочего каталога.
Сохраняем файл и перезапускаем Redis:
sudo systemctl restart redis-serverПроверяем:
sudo systemctl is-active redis-serverТеперь смотрим, применились ли настройки:
redis-cli CONFIG GET appendonlyОжидаем:
    appendonly
yes
И:
redis-cli CONFIG GET appendfsyncОжидаем:
    appendfsync
everysec
Статус persistence:
redis-cli INFO persistenceНас интересуют параметры AOF, например:
    aof_enabled
aof_rewrite_in_progress
aof_last_rewrite_time_sec
aof_last_bgrewrite_status
При включенном AOF ожидаем:
aof_enabled:1Теперь persistence работает уже не только через RDB snapshots, но и через append-only механизм.
Следующий шаг — проверить самый важный сценарий: действительно ли созданные keys переживут restart Redis и полный reboot VPS.
Проверяем сохранность данных после перезапуска
Создаем контрольные ключи
Создадим несколько разных значений:
    redis-cli SET app:persistence:string "survives-restart"
redis-cli SET app:persistence:counter 42
redis-cli HSET app:persistence:user name "Alice" role "admin"
Если используется app_user, выполняем команды через него.
Проверим:
redis-cli GET app:persistence:stringОжидаем:
"survives-restart"Счетчик:
redis-cli GET app:persistence:counterРезультат:
"42"Hash:
redis-cli HGETALL app:persistence:userТеперь у нас есть несколько легко узнаваемых контрольных значений.
Перед restart полезно еще раз убедиться, что persistence активна:
redis-cli INFO persistenceИ посмотреть состояние RDB/AOF.
Перезапускаем Redis
Теперь выполняем обычный restart:
sudo systemctl restart redis-serverПосле этого проверяем сервис:
sudo systemctl is-active redis-serverОжидаем:
activeСам restart очищает RAM процесса, поэтому если persistence работает неправильно, ключи здесь как раз и могут пропасть.
Теперь проверим данные.
Проверяем восстановление
Читаем первый key:
redis-cli GET app:persistence:stringОжидаем:
"survives-restart"Счетчик:
redis-cli GET app:persistence:counterОжидаем:
"42"Hash:
redis-cli HGETALL app:persistence:userЕсли все значения на месте, Redis успешно восстановил состояние после restart.
Полная цепочка выглядит так:
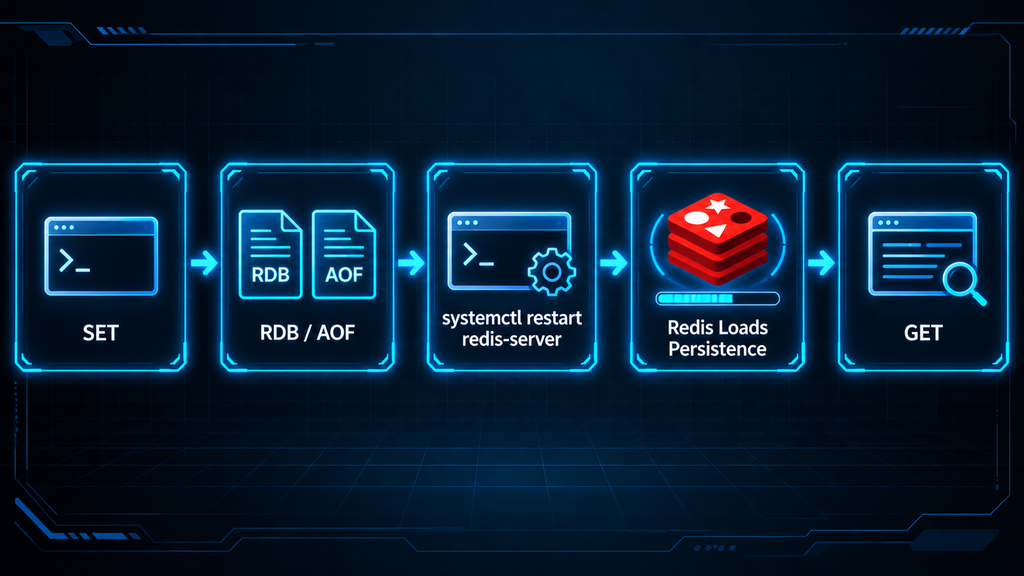
Но restart сервиса — это еще не то же самое, что полная перезагрузка VPS.
Чем restart отличается от полного reboot VPS
При:
sudo systemctl restart redis-serverперезапускается только Redis.
Операционная система продолжает работать, временные файлы и кэши остаются на месте, disk остается подключенным, а остальные сервисы не меняются.
При:
sudo rebootперезагружается весь VPS.
Это позволяет проверить сразу несколько вещей:
- Запускается ли Redis автоматически;
- Сохраняются ли настройки;
- Доступны ли persistence-файлы после boot;
- Восстанавливаются ли данные;
- Остаются ли ACL и сетевые параметры.
Поэтому для финальной проверки лучше пройти оба сценария.
Проверяем данные после reboot
Перезагружаем VPS:
sudo rebootПосле повторного подключения по SSH сначала проверяем сервис:
sudo systemctl status redis-serverИ коротко:
sudo systemctl is-active redis-serverЕсли автозапуск работает, получим:
activeТеперь снова читаем контрольный key:
redis-cli GET app:persistence:stringОжидаем:
"survives-restart"Проверяем счетчик:
redis-cli GET app:persistence:counterИ hash:
redis-cli HGETALL app:persistence:userЕсли все три значения вернулись, persistence пережила уже не только restart процесса, но и полный reboot VPS.
Можно дополнительно посмотреть:
redis-cli INFO persistenceи убедиться, что AOF/RDB снова загружены без ошибок.
Redis как кеш и Redis как хранилище
Теперь у нас настроены и ограничения памяти, и persistence. Осталось связать эти механизмы с реальной задачей приложения, потому что одна и та же конфигурация Redis не подходит одновременно для всех сценариев.
Главный вопрос здесь простой: можно ли восстановить данные из другого источника, если Redis их потеряет? Если да, перед нами в первую очередь кеш. Если нет, Redis уже становится частью системы хранения, а требования к eviction, TTL и persistence заметно меняются.
Когда Redis используют только как кеш
Классический сценарий Redis — хранить копию данных, которые уже существуют где-то еще.
Например:
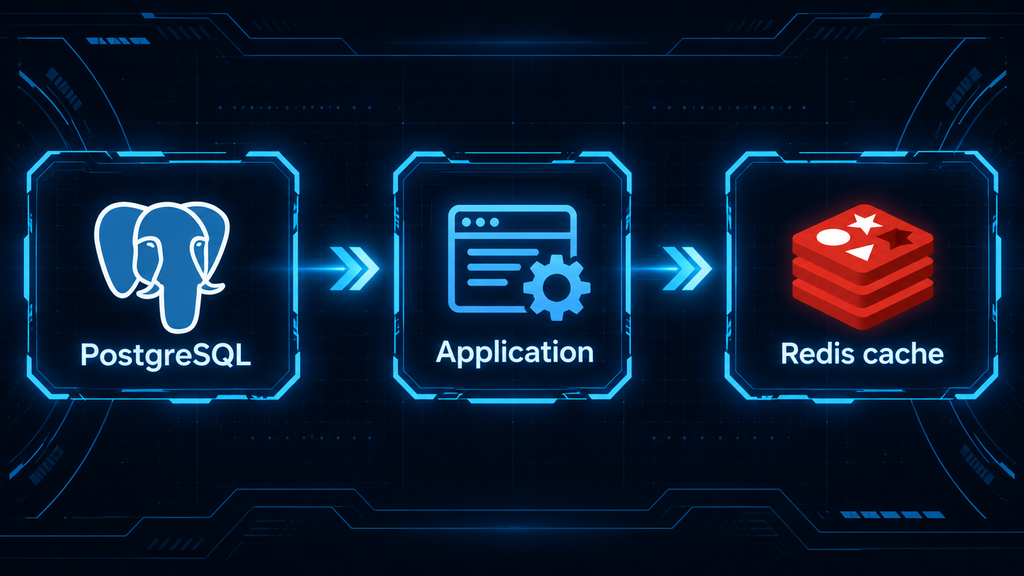
Приложение сначала проверяет Redis. Если нужный key найден, данные возвращаются сразу. Если нет — приложение читает их из основной database и снова помещает в Redis.
В таком случае удаление key не означает потерю исходных данных. Максимум следующий запрос будет немного медленнее, потому что кеш придется заполнить заново.
Для такого сценария хорошо подходят:
maxmemory-policy allkeys-lruили:
maxmemory-policy allkeys-lfuПри заполнении памяти Redis сможет автоматически освобождать место под новые данные.
Persistence здесь тоже не всегда обязательна. Если после restart кеш можно спокойно прогреть заново, RDB и AOF только добавят disk I/O и усложнят конфигурацию. Если же повторное заполнение большого кеша занимает много времени и создает нагрузку на основную database, RDB может помочь быстрее вернуть сервер в рабочее состояние.
С кешем все относительно просто. Сложнее становится, когда Redis хранит состояние, которого больше нигде нет.
Когда Redis становится частью постоянного хранения
Redis перестает быть просто кешем, если потеря key означает потерю реального состояния приложения.
Например, там могут находиться:
- Counters;
- Очереди;
- Состояние задач;
- Rate-limit state, который важно сохранять;
- Session data, если другого источника нет;
- Промежуточное состояние workflow;
- Другие данные, которые нельзя автоматически пересоздать.
В таком случае уже опасно считать любой key расходным материалом.
Если настроить:
allkeys-lruRedis при нехватке памяти имеет право удалить key, который приложение все еще считает важным.
Поэтому для storage-like сценария безопаснее рассматривать:
maxmemory-policy noevictionТогда при заполнении памяти проблема проявится явно: новые операции, требующие дополнительной RAM, начнут завершаться ошибкой, но Redis не станет самостоятельно освобождать место за счет существующих данных.
Одновременно возрастает значение persistence. Если состояние важно, Redis должен иметь возможность восстановить его после restart или сбоя.
Получается, роль Redis напрямую определяет сразу две настройки:
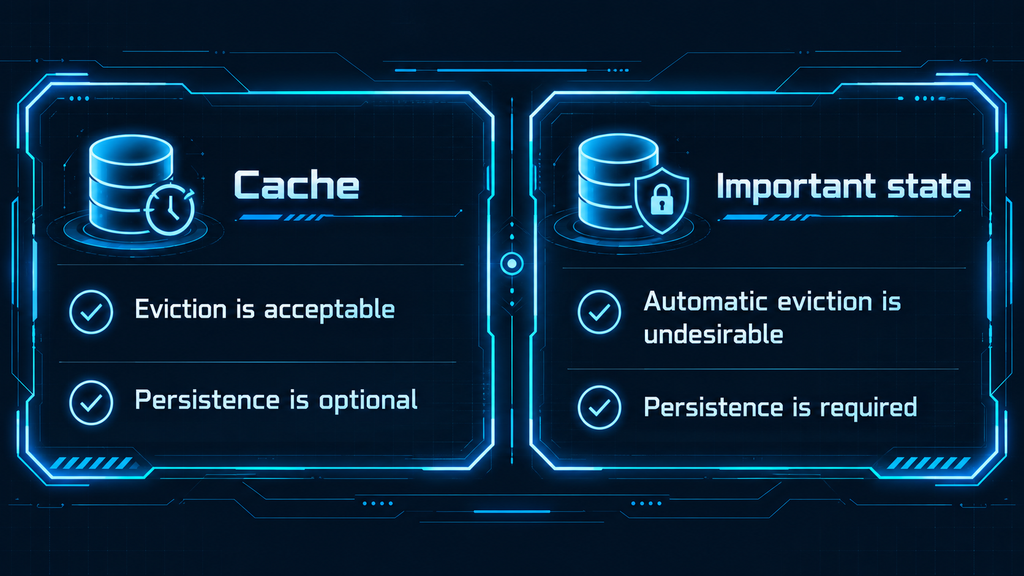
Теперь можно точнее разобрать связь между этими механизмами.
Как меняются eviction и persistence
Eviction и persistence решают совершенно разные задачи.
maxmemory-policy определяет: что делать, если Redis закончилась разрешенная память.
Persistence определяет: откуда восстановить данные после restart.
Поэтому включенный AOF не защищает key от eviction.
Если используется:
maxmemory-policy allkeys-lruRedis может удалить key из рабочего набора, а persistence затем зафиксирует уже новое состояние без этого key.
То же самое работает и в обратную сторону: noeviction не защищает от потери данных после аварийного restart, если persistence полностью отключена.
Следовательно, эти параметры нужно выбирать вместе.
Для кеша может быть нормальной комбинация:
maxmemory-policy allkeys-lrupersistence disabled
Для более важного состояния:
    maxmemory-policy noeviction
appendonly yes
appendfsync everysec
И это уже принципиально разные модели эксплуатации Redis.
Между ними есть промежуточные варианты. Например, временные данные могут иметь ценность во время работы приложения, но автоматически устаревать через несколько минут или часов. Здесь на первый план выходит TTL.
Что делать с TTL
TTL определяет, сколько времени key должен существовать.
Например:
SET app:cache:user:42 "..." EX 300создает key на пять минут.
Посмотреть оставшееся время можно командой:
TTL app:cache:user:42TTL особенно полезен для:
- Кеша;
- Sessions;
- Временных tokens;
- Rate limiting;
- Промежуточных результатов;
- Данных, которые имеют естественный срок жизни.
Для кеша правило обычно простое: если данные со временем перестают быть актуальными, expiration лучше задавать явно.
Иначе Redis может накопить огромное количество keys, которые приложение уже никогда не прочитает.
Но TTL не стоит добавлять механически ко всем данным. Если key хранит состояние, которое должно существовать до явного изменения или удаления, случайный expiration превращается уже в риск потери данных.
Поэтому стоит заранее определить жизненный цикл каждого типа keys:
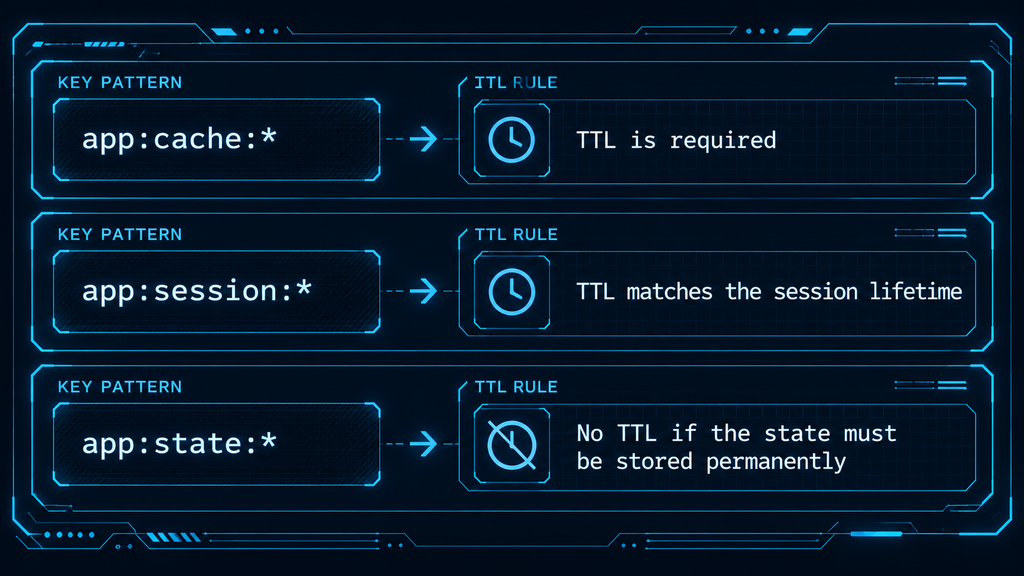
Так поведение Redis становится гораздо предсказуемее.
Какие настройки выбрать для каждого сценария
На практике удобно выделить не два, а три сценария: обычный кеш, временные данные приложения и более постоянное состояние.
| Сценарий | Eviction | Persistence | TTL | Что учитывать |
| Кеш | allkeys-lru / allkeys-lfu | Можно отключить | Обычно нужен | Данные можно получить заново |
| Временные данные | Зависит от допустимости потери | RDB или AOF по необходимости | Обычно нужен | Нужно понимать срок жизни и последствия удаления |
| Постоянное состояние | noeviction | Обычно AOF или RDB+AOF | Только если expiration предусмотрен логикой | Нельзя допускать незаметную потерю keys |
Эта таблица — отправная точка, а не универсальный шаблон. Например, session store вполне может переживать автоматическое удаление старых sessions в одном проекте и считаться критичным компонентом в другом.
Главное — заранее ответить на три вопроса:
- Можно ли восстановить key из другого источника?
- Допустимо ли Redis удалить его при заполнении памяти?
- Должен ли key вернуться после restart?
Ответы практически напрямую определяют TTL, eviction policy и persistence.
С ролью Redis определились. Теперь можно перейти к ситуации, когда расчет памяти оказался слишком оптимистичным или dataset неожиданно вырос: разберем, как выглядит нехватка RAM и где искать причину.
Диагностируем нехватку памяти
Проблема с памятью Redis не всегда выглядит как падение сервиса. Иногда redis-server продолжает нормально отвечать на GET, но новые записи внезапно перестают проходить. В другом случае приложение работает без ошибок, зато Redis постоянно вытесняет тысячи keys из кеша.
Поэтому диагностировать нужно не один показатель, а сразу несколько: used_memory, maxmemory, выбранную policy, число eviction и состояние памяти самого VPS.
Как выглядит OOM command not allowed
Самый очевидный сценарий возникает при:
maxmemory-policy noevictionКогда Redis достигает maxmemory и очередная команда требует дополнительной памяти, запись завершается OOM-ошибкой.
Например:
SET app:test "value"может вернуть сообщение вида:
OOM command not allowed when used memory > 'maxmemory'.При этом сам Redis не обязательно сломан.
Он продолжает работать, а операции, которым не требуется дополнительное выделение памяти, могут выполняться дальше. Например, существующие keys по-прежнему можно читать.
Поэтому OOM в этом случае означает не Redis упал, а: Redis достиг настроенного лимита + policy не позволяет освобождать память автоматически
Первым делом после такой ошибки нужно посмотреть фактическое потребление.
Как проверить used_memory
Основная команда:
redis-cli INFO memoryДля быстрого просмотра:
redis-cli INFO memory | grep -E "used_memory_human|used_memory_peak_human|maxmemory_human"Например:
    used_memory_human:1.98G
used_memory_peak_human:2.01G
maxmemory_human:2.00G
Если used_memory практически достиг maxmemory, причина OOM становится очевидной.
Дополнительно полезно посмотреть:
used_memory_peakОн показывает, насколько высоко потребление поднималось с момента запуска Redis.
Иногда текущая память уже снизилась, но высокий peak помогает понять, что раньше сервер действительно подходил к пределу.
После этого проверяем сам лимит — возможно, он вообще не соответствует текущему размеру dataset.
Как проверить maxmemory
Текущее значение:
redis-cli CONFIG GET maxmemoryИ policy:
redis-cli CONFIG GET maxmemory-policyНапример:
    maxmemory
2147483648
и:
    maxmemory-policy
noeviction
Получаем вполне понятную картину:
used_memory ≈ 2 ГБ
maxmemory = 2 ГБ
policy = noeviction
В таком состоянии новые записи вполне ожидаемо могут завершаться OOM.
Но если используется eviction policy, приложение может вообще не увидеть ошибки. Redis начнет освобождать память самостоятельно.
Тогда нужно смотреть статистику вытеснения.
Как увидеть eviction
Количество удаленных из-за нехватки памяти keys можно посмотреть через:
redis-cli INFO stats | grep evicted_keysНапример:
evicted_keys:18432Если значение постоянно растет, Redis регулярно достигает maxmemory и освобождает место.
Сам факт eviction для кеша не является ошибкой. Именно для этого мы и включаем allkeys-lru или allkeys-lfu.
Вопрос в масштабе.
Если приложение постоянно теряет кеш, hit rate падает, а evicted_keys быстро увеличивается, памяти может быть недостаточно для нормального working set.
То есть:
evicted_keysрастет медленно → нормальная работа ограниченного кешаevicted_keysрастет постоянно и быстро → вероятно, кешу тесно
Здесь уже имеет смысл проверить размер dataset, TTL и реальную полезность хранящихся keys.
Но иногда возникает другая странность: Redis сообщает один объем памяти, а Linux показывает процесс значительно крупнее.
Почему память процесса может быть больше размера данных
Например, Redis показывает:
used_memory_human:1.30Gа в top или ps процесс занимает заметно больше.
Это не обязательно утечка памяти.
Разница может появляться из-за:
- allocator overhead;
- memory fragmentation;
- client buffers;
- copy-on-write;
- фоновых RDB/AOF операций;
- служебных структур;
- особенностей того, как Linux учитывает RSS.
Сравнить показатели можно через:
redis-cli INFO memoryОсобенно интересны:
    used_memory
used_memory_rss
mem_fragmentation_ratio
А на уровне ОС:
ps -C redis-server -o pid,%mem,rss,vsz,cmdи:
free -hТо есть смотреть только на размер stored values недостаточно. Redis — работающий процесс со своими buffers, структурами и allocator.
Если же RSS неожиданно растет вместе с дефицитом системной RAM, нужно уже проверить persistence и фоновые процессы.
Что делать при нехватке RAM
После диагностики не стоит сразу увеличивать maxmemory.
Сначала нужно понять, почему памяти стало мало.
Если Redis используется как кеш, можно проверить:
- Правильно ли выставлены
TTL; - Не остаются ли ненужные keys без expiration;
- Подходит ли текущая eviction policy;
- Можно ли уменьшить размер values;
- Не слишком ли велик кеш относительно VPS.
Посмотреть количество keys можно:
redis-cli DBSIZEДля анализа keyspace:
redis-cli INFO keyspaceЕсли проблема не в мусорных данных, а working set действительно вырос, следующий вариант — увеличить RAM VPS и затем пересчитать maxmemory.
Для storage-like Redis с noeviction ситуация еще строже. Здесь нельзя просто включить allkeys-lru, чтобы убрать OOM, если удаление данных недопустимо. Нужно либо освободить память осознанно, либо увеличить сервер, либо изменить архитектуру хранения.
Отдельно проверяем системную RAM:
free -hи swap:
swapon --showЕсли Redis активно вытесняется в swap, latency может заметно вырасти. Поэтому swap лучше оставлять аварийным резервом, а не использовать как способ разместить dataset, который физически не помещается в RAM.
Основные симптомы удобно свести вместе:
| Симптом | Возможная причина | Что проверить | Что делать |
OOM command not allowed | Redis достиг maxmemory при noeviction | INFO memory, CONFIG GET maxmemory-policy | Освободить память, увеличить лимит вместе с RAM или уменьшить dataset |
evicted_keys быстро растет | Кеш постоянно упирается в лимит | INFO stats | Проверить TTL, policy и размер VPS |
used_memory почти равен maxmemory | Рабочий набор заполнил лимит | INFO memory | Оценить dataset и необходимый запас |
RSS заметно выше used_memory | Fragmentation, buffers или фоновые операции | INFO memory, ps, free -h | Проверить fragmentation, clients и persistence |
| VPS активно использует swap | Redis и остальные процессы не помещаются в RAM | free -h, swapon --show | Уменьшить потребление или увеличить RAM |
| Redis process завершен системой | Закончилась системная память | journalctl, system logs | Увеличить запас RAM и уменьшить maxmemory |
Диагностику поэтому лучше вести от общего к частному: сначала убедиться, что VPS не испытывает системный memory pressure, затем сравнить used_memory с maxmemory, проверить policy и только после этого смотреть eviction и структуру dataset.
Проверяем Redis после перезагрузки
Что должно запуститься автоматически
После установки мы включили автозапуск Redis через systemd:
sudo systemctl enable redis-serverПоэтому после reboot должен автоматически подняться:
redis-server.serviceВместе с сервисом должны примениться настройки из:
/etc/redis/redis.confТо есть после перезагрузки мы ожидаем, что сохранятся:
- Bind;
- Protected-mode;
- ACL;
- Maxmemory;
- Maxmemory-policy;
- RDB/AOF;
- Контрольные данные, если persistence настроена правильно.
Теперь проверим это по шагам.
Проверяем service
Перезагружаем VPS:
sudo rebootПосле повторного подключения по SSH смотрим состояние Redis:
sudo systemctl status redis-serverКороткая проверка:
sudo systemctl is-active redis-serverОжидаем:
activeДополнительно проверим автозапуск:
sudo systemctl is-enabled redis-serverОжидаемый результат:
enabledЕсли сервис после reboot не поднялся, первым делом смотрим журнал текущей загрузки:
sudo journalctl -u redis-server -b --no-pagerТак можно быстро понять, проблема в redis.conf, правах на persistence-файлы или самом запуске сервиса.
Следом проверим, что Redis не только работает, но и по-прежнему требует authentication.
Проверяем authentication
Сначала пробуем обратиться без credentials:
redis-cli GET app:persistence:stringЕсли ACL настроены правильно, Redis не должен отдавать защищенные данные анонимному клиенту.
Теперь подключаемся под app_user:
    redis-cli \
  --user app_user \
  --pass StrongPassword123
Внутри проверяем:
PINGОжидаем:
PONGИ читаем разрешенный key:
GET app:persistence:stringЕсли login проходит, а данные доступны только в рамках разрешенных ACL, значит authentication после reboot сохранилась корректно.
Теперь можно переходить к самим данным.
Проверяем данные
Ранее мы создавали контрольные keys:
    app:persistence:string
app:persistence:counter
app:persistence:user
Проверим первый:
    redis-cli \
  --user app_user \
  --pass StrongPassword123 \
  GET app:persistence:string
Ожидаем:
"survives-restart"Счетчик:
    redis-cli \
  --user app_user \
  --pass StrongPassword123 \
  GET app:persistence:counter
И hash:
    redis-cli \
  --user app_user \
  --pass StrongPassword123 \
  HGETALL app:persistence:user
Если значения сохранились, persistence пережила полный reboot VPS.
Можно дополнительно проверить состояние RDB/AOF:
redis-cli INFO persistenceНас интересует, что persistence включена и Redis не сообщает об ошибках последнего snapshot или AOF rewrite.
Осталось проверить, что настройки памяти тоже не сбросились.
Проверяем maxmemory и eviction policy
Сначала смотрим лимит:
redis-cli CONFIG GET maxmemoryЕсли мы оставили рабочее значение:
maxmemory 2gbRedis должен вернуть эквивалентное число в bytes.
Теперь policy:
redis-cli CONFIG GET maxmemory-policyНапример:
allkeys-lruили:
noevictionв зависимости от выбранного сценария.
Дополнительно можно проверить память:
redis-cli INFO memory | grep -E "used_memory_human|maxmemory_human"И eviction:
redis-cli INFO stats | grep evicted_keysТак мы убеждаемся, что после reboot Redis не только запустился, но и сохранил нужное поведение при ограничении памяти.
Итоговую проверку можно свести в короткую таблицу:
| Что проверяем | Команда | Ожидаемый результат |
| Service | systemctl is-active redis-server | active |
| Auth | redis-cli --user app_user --pass ... | Успешный вход |
| Memory | CONFIG GET maxmemory | Рабочий лимит |
| Persistence | INFO persistence | RDB/AOF без ошибок |
| Data | GET app:persistence:string | Контрольный key существует |
Если все пять уровней проходят после reboot, Redis действительно возвращается в рабочее состояние автоматически: сервис стартует, ACL сохраняются, данные восстанавливаются, а память и eviction policy остаются такими же, как до перезагрузки.
Как безопасно использовать Redis в production
Теперь конфигурация уже не выглядит как тестовый стенд: сеть ограничена, ACL настроены, память контролируется, а persistence проверена на restart и reboot. Перед production остается закрепить несколько правил, чтобы Redis не стал источником неожиданных проблем уже под реальной нагрузкой.
Не использовать Redis без ограничения сети
Redis не стоит выставлять на 6379 для всего интернета даже при наличии password.
Если приложение работает на том же VPS, лучший вариант — оставить:
bind 127.0.0.1Если используется отдельный Application VPS, предпочтительнее private network и firewall с разрешением только конкретного source IP.
Иначе получается слишком широкий контур доступа, который потом сложно контролировать.
Логика должна быть простой: нужный interface + firewall + ACL, а не «порт открыт всем, но зато есть пароль».
Разделять пользователей и ACL
Приложение должно подключаться под отдельным пользователем, а не через unrestricted default user.
Для каждого сервиса лучше определять:
- Отдельный username;
- Отдельный password;
- Разрешенные commands;
- Допустимые key patterns.
Например:
app_user→ ~app:*
→ GET / SET / DEL / EXPIRE
Если позже появится отдельный worker или analytics service, для него можно создать собственную ACL.
Так проще менять credentials, отключать отдельный сервис и не выдавать всем одинаковые права.
Не выделять Redis всю RAM сервера
maxmemory не должен быть равен физической RAM VPS.
Нужно оставить запас:
- Операционной системе;
- Systemd и SSH;
- Buffers;
- Fragmentation;
- RDB/AOF;
- Copy-on-write при fork;
- Другим сервисам.
Для VPS с 4 ГБ RAM мы выбрали около:
maxmemory 2gbкак консервативную отправную точку.
На production точное значение лучше пересматривать уже по фактическому used_memory, нагрузке и поведению persistence.
Выбирать eviction policy под задачу
Eviction policy должна соответствовать типу данных.
Для обычного кеша можно использовать:
allkeys-lruили:
allkeys-lfuЕсли данные нельзя удалять автоматически:
noevictionБезопаснее получить явную OOM-ошибку, чем потерять важный key из-за автоматического eviction.
Поэтому policy нельзя выбирать отдельно от роли Redis.
Настраивать persistence осознанно
RDB и AOF решают разные задачи.
RDB хорошо подходит для периодических snapshots и быстрого восстановления состояния.
AOF лучше сохраняет последние изменения и обычно полезнее там, где потеря свежих записей нежелательна.
Для чистого кеша persistence иногда вообще не нужна.
Для более важных данных можно использовать:
    appendonly yes
appendfsync everysec
или комбинацию RDB+AOF.
Главное — понимать, какую потерю данных приложение реально может пережить.
Хранить резервные копии вне VPS
Persistence-файл на том же сервере — это еще не полноценный backup.
Если VPS потеряет disk или будет удален, вместе с Redis исчезнут и:
dump.rdbи AOF.
Поэтому копии нужно периодически переносить на отдельное хранилище:
- Object Storage;
- Backup VPS;
- Отдельный storage;
- Другую fault domain.
Локальный snapshot полезен для быстрого recovery, но не должен быть единственной копией.
Контролировать память, disk и logs
Redis полезно проверять не тогда, когда он уже начал отдавать OOM, а заранее.
Базовый набор:
    redis-cli INFO memory
redis-cli INFO stats
redis-cli INFO persistence
На уровне системы:
    free -h
df -h
И логи:
sudo journalctl -u redis-server -n 100 --no-pagerОсобенно стоит следить за:
used_memory;maxmemory;evicted_keys;- persistence errors;
- свободным disk space;
- использованием swap.
Если AOF или RDB активно растут, нехватка диска может стать такой же проблемой, как и нехватка RAM.
Обновлять Redis последовательно
Major upgrades лучше не делать вслепую.
Перед обновлением стоит проверить:
- Текущую версию;
- Целевую версию;
- Совместимость конфигурации;
- Изменения ACL;
- Формат persistence;
- Совместимость client libraries.
Версия Redis:
redis-server --versionПеред крупным upgrade полезно иметь свежую внешнюю копию RDB/AOF и понятный rollback-план.
После обновления повторяем уже знакомые проверки:
    sudo systemctl status redis-server
redis-cli PING
redis-cli INFO persistence
и отдельно проверяем ACL, maxmemory, policy и данные.
Что проверить перед production
Перед запуском приложения достаточно пройти три коротких чеклиста.
Сеть и доступ
- Redis не открыт всему интернету;
bindсодержит только нужные interfaces;- firewall ограничивает source IP;
- приложение работает под отдельным ACL-пользователем;
- administrative commands приложению не доступны.
Память и persistence
maxmemoryоставляет запас VPS;maxmemory-policyсоответствует роли Redis;- RDB/AOF настроены осознанно;
- контрольные данные переживают restart и reboot;
- backup уходит за пределы Redis VPS.
Эксплуатация
redis-serverстартует автоматически;used_memoryиevicted_keysконтролируются;- disk space не заканчивается;
- logs доступны для диагностики;
- upgrade выполняется с backup и проверкой после обновления.
Если эти пункты закрыты, standalone Redis на VPS уже становится вполне предсказуемым production-компонентом: сеть ограничена, права разделены, память контролируется, а поведение при restart и нехватке RAM заранее понятно.
Заключение
Standalone Redis на одном VPS хорошо подходит для небольших и средних проектов, где он используется как кеш, session store, rate limiter или хранилище оперативного состояния. При этом важно заранее настроить ACL, ограничить сетевой доступ, задать maxmemory, выбрать подходящую eviction policy и проверить persistence после restart.
Если Redis начинает хранить критичные данные или простой сервиса становится недопустимым, одного VPS уже мало. Тогда стоит переходить к replication, Sentinel, Redis Cluster или managed Redis.
Спасибо за внимание!
FAQ
Обязательно ли включать persistence, если Redis используется только как кеш?
Нет. Если все данные в Redis можно получить заново из основной database или другого источника, persistence может быть не нужна вообще.
После restart кеш просто заполнится заново.
Однако RDB иногда имеет смысл даже для кеша, если его повторный прогрев занимает много времени или создает большую нагрузку на основное хранилище.
Что лучше использовать — RDB или AOF?
Зависит от требований к восстановлению.
RDB создает периодические snapshots и хорошо подходит, когда допустима потеря изменений между ними. AOF записывает операции изменения данных и позволяет уменьшить объем потенциально потерянных последних записей.
Для большинства сценариев с AOF хорошей отправной точкой будет:
appendfsync everysecЕсли нужны преимущества обоих механизмов, RDB и AOF можно использовать одновременно.
Можно ли включить RDB и AOF одновременно?
Да.
Например, можно оставить автоматические RDB snapshots и одновременно включить:
    appendonly yes
appendfsync everysec
Тогда Redis будет вести AOF и параллельно создавать RDB snapshots.
Такая конфигурация требует больше disk I/O и немного усложняет эксплуатацию, поэтому для простого восстанавливаемого кеша она может быть избыточной.
Потеряются ли данные после systemctl restart redis-server?
Если persistence отключена — данные, находившиеся только в RAM, будут потеряны.
Если корректно настроены RDB или AOF и нужные изменения успели попасть в persistence-файлы, Redis загрузит их при следующем запуске.
Именно поэтому persistence лучше проверять практически: создать контрольный key, выполнить restart и затем снова прочитать его.
Что произойдет, когда Redis достигнет maxmemory?
Все зависит от:
maxmemory-policyПри noeviction Redis не будет автоматически удалять существующие keys, а команды, которым нужна дополнительная память, начнут завершаться ошибкой.
При eviction policies вроде allkeys-lru или allkeys-lfu Redis начнет освобождать место, удаляя подходящие keys.
Какую eviction policy выбрать для обычного кеша?
Для универсального кеша обычно удобно начинать с:
allkeys-lruили:
allkeys-lfuLRU старается удалять давно неиспользуемые keys, а LFU — редко используемые.
Конкретный выбор зависит от нагрузки: если важнее удерживать постоянно востребованные hot keys, LFU может оказаться полезнее. Если данные имеют более выраженный временной характер, LRU часто дает понятное поведение.
Почему при noeviction Redis перестает принимать записи?
Потому что noeviction запрещает Redis освобождать память путем автоматического удаления существующих keys.
Когда достигается maxmemory, операции, которым требуется дополнительная память, могут завершаться OOM-ошибкой. При этом чтение существующих данных продолжает работать.
Почему used_memory меньше памяти процесса Redis?
used_memory показывает память, выделенную Redis через allocator, а RSS процесса дополнительно отражает то, как память фактически представлена операционной системе.
Разница может появляться из-за fragmentation, allocator behavior, buffers, прошлых пиков потребления и других факторов.
Для сравнения удобно смотреть:
redis-cli INFO memoryи показатели:
    used_memory
used_memory_rss
used_memory_peak
mem_fragmentation_ratio
used_memory_rss как раз соответствует resident set size, который видят системные утилиты вроде top и ps.
Можно ли изменить maxmemory без restart Redis?
Да, рабочую конфигурацию можно изменить через:
redis-cli CONFIG SET maxmemory 2gbи аналогично поменять policy.
Но если настройка должна сохраниться после restart, ее нужно зафиксировать в постоянной конфигурации Redis. Иначе после перезапуска сервер может вернуться к значениям из redis.conf.
Зачем оставлять Redis свободную RAM, если уже настроен maxmemory?
Потому что maxmemory не является полным лимитом RSS всего процесса и не учитывает потребности операционной системы.
Дополнительная память может понадобиться на buffers, allocator overhead, fragmentation и copy-on-write во время RDB snapshot или AOF rewrite.
Поэтому значение вроде:
maxmemory 4gbна VPS ровно с 4 ГБ RAM было бы слишком агрессивным.
Безопасно ли открыть 6379 всему интернету, если Redis защищен паролем?
Так делать не стоит.
Redis лучше размещать в доверенной сети и ограничивать порт как минимум через bind, firewall и ACL. Если приложение находится на другом сервере, предпочтительнее private network или разрешение только конкретного доверенного source IP.
Сам Redis рассчитан прежде всего на работу с доверенными клиентами, а не на прямой доступ произвольных клиентов из интернета.
Можно ли использовать Redis как основное хранилище данных?
Можно строить системы, где Redis хранит важное состояние, но в таком случае его уже нельзя эксплуатировать как обычный disposable cache.
Понадобятся подходящая persistence, контролируемая eviction policy, резервные копии и продуманное восстановление. Если потеря данных недопустима, также стоит учитывать отказоустойчивость самого сервера — standalone Redis остается единственной точкой отказа.
Что делать, если AOF поврежден?
В первую очередь не стоит удалять исходный persistence-файл и запускать случайные команды восстановления поверх единственной копии.
Сохраните копию AOF, остановите запись в проблемный экземпляр и только после этого занимайтесь восстановлением. Полезно также иметь отдельный backup — например, RDB snapshot или копию persistence на другом сервере.
Это еще одна причина не считать локальный AOF полноценной заменой резервному копированию.
Где Redis хранит RDB и AOF?
Каталог определяется параметром:
dirПроверить его можно так:
redis-cli CONFIG GET dirИмя RDB:
redis-cli CONFIG GET dbfilenameА параметры AOF:
    redis-cli CONFIG GET appendonly
redis-cli CONFIG GET appendfilename
При пакетной установке рабочие persistence-файлы обычно находятся в каталоге Redis внутри /var/lib, но точный путь лучше проверять по текущей конфигурации.
Нужен ли Redis swap?
Небольшой swap можно оставить как аварийную страховку для всего VPS, но использовать его как продолжение RAM для Redis не стоит.
Redis рассчитан на работу с данными в оперативной памяти. Если значительная часть его memory pages постоянно вытесняется в swap, latency может резко вырасти.
Поэтому если рабочий dataset регулярно не помещается в физическую RAM, правильнее пересмотреть maxmemory, уменьшить dataset или увеличить объем памяти сервера.